


Ray Tracing: The Rest of Your Life 12장을 우리 CUDA + 레이트레이싱 프로젝트 기준으로 정리한 문서. 원서의 논지를 빠짐없이 따라가되 설명은 우리 말로 다시 썼고, 코드는 전부 우리 GPU 코드다.
원서: Ray Tracing: The Rest of Your Life (v4.0.2) · 커밋 28a2ef6
 이 장에서 CUDA 때문에 달라지는 큰 그림
1. 재질이 돌려주는 값이 많아져서(감쇠, PDF, 정반사 여부, 정반사 레이) ScatterRecord 하나로 묶는다. 원서는 shared_ptr<pdf>를 담지만, 우리는 PDF를 값으로 품고 포인터로 가리킨다 — 바운스마다 디바이스 new를 하지 않기 위해서다.
2. Pdf.h와 Material.h가 서로를 필요로 하게 되어 Sampling.h 로 공통 도우미(π, 방향 생성기)를 뺐다.
3. 정반사는 bSkipPdf 플래그로 명시화했다. 우리는 6장부터 "pdf == 0이면 감쇠만" 규칙을 지켜 왔으므로, 원서처럼 중간에 거울·유리가 깨진 적이 없다.
4. Sphere와 HittableList도 샘플링 대상이 된다 → 광원이 여럿(천장 광원 + 유리 구)인 장면이 가능해진다.
5. PPM 출력에 NaN 가드를 넣었다.
무엇이 문제인가
10장에서 만든 혼합 밀도는 잘 동작했지만, 구조를 보면 불편한 곳이 있다. RayColor 안에 PDF 두 개가 하드코딩되어 있다.
1.
하나는 광원의 모양에 딸린 PDF (HittablePdf)
2.
다른 하나는 법선과 표면의 종류에 딸린 PDF (CosinePdf)
둘 다 RayColor가 직접 만들어 쓴다. 그런데 1번은 장면이 아는 정보고, 2번은 재질이 아는 정보다. RayColor가 둘 다 알아야 할 이유가 없다.
고칠 방향은 명확하다.
•
샘플링하고 싶은 물체(광원이든 무엇이든)를 RayColor의 인자로 넘긴다. → 10장에서 이미 lights를 넘기도록 해 두었다.
•
재질에게 "네 PDF를 내놔" 라고 물어본다. → 이번 장의 주된 작업이다.
여기에 한 가지가 더 필요하다. 산란된 레이가 정반사인지 아닌지를 알아야 한다. 거울이나 유리는 방향이 하나로 정해지는 델타 분포라 밀도로 나눌 수 없기 때문이다. 이 정보는 Hit에게 물어볼 수도 있고 재질에게 물어볼 수도 있는데, 재질에게 묻는 쪽이 자연스럽다.
확산이냐 정반사냐: ScatterRecord
우리가 지원하고 싶은 재질 중에는 니스 칠한 나무처럼 일부는 이상적인 정반사(광택), 일부는 확산(나무결)인 것이 있다. 이런 재질을 다루는 방법은 크게 둘이다.
•
레이를 두 개 만든다: 정반사 하나, 확산 하나. 결과는 정확하지만 레이가 분기(branch) 하며 늘어난다.
•
무작위로 하나를 고른다: 이번 산란이 정반사인지 확산인지 재질이 확률적으로 정한다.
원서는 두 번째를 택한다("분기를 좋아하지 않는다"). GPU에서는 이 선택이 더욱 중요하다 — 바운스마다 레이가 2배로 늘어나면 워프 안 스레드들이 서로 다른 개수의 일을 하게 되고, RayColor의 반복 루프 구조 자체가 무너진다. 레이 하나가 경로 하나를 따라간다는 불변식은 GPU 경로 추적기의 전제다.
대신 조심할 것이 생긴다. PDF 값을 물어볼 때 이번 산란이 확산인지 확인해야 한다. 다행히 우리는 "확산일 때만 PdfValue를 부른다"는 규칙을 이미 정해 두었으므로, 플래그 하나면 암묵적으로 처리된다.
이제 재질이 돌려줘야 할 값이 네 개가 되었다 — 감쇠, PDF, 정반사 여부, 정반사 레이. 인자 목록을 계속 늘리는 대신 HitRecord 때 했던 것처럼 구조체로 묶는다.
 파일: Material.h — 원서 Listing material-refactor에 대응
struct ScatterRecord
{
Color Attenuation;
const Pdf* PdfPtr; // bSkipPdf == false일 때 유효 (아래 저장소 중 하나를 가리킨다)
bool bSkipPdf;
Ray SkipPdfRay; // bSkipPdf == true일 때 따라갈 레이
// PDF 저장소(디바이스 new 회피용)
CosinePdf CosinePdfStorage;
SpherePdf SpherePdfStorage;
__device__ ScatterRecord() : PdfPtr(nullptr), bSkipPdf(false) {}
};
C++
복사
 CUDA 메모 — shared_ptr 대신 값 저장소: 원서는 make_shared<cosine_pdf>(rec.normal)로 힙에 PDF를 만든다. 이것은 바운스마다 힙 할당 한 번이라는 뜻이다. CPU에서도 싸지 않지만, GPU에서는 아예 불가능에 가깝다 — 디바이스 new는 미리 잡아 둔 작은 디바이스 힙을 쓰고, 수십만 스레드가 동시에 두드리면 직렬화되거나 힙이 터진다.
그래서 쓸 수 있는 PDF들을 ScatterRecord 안에 값으로 품고 있다가 PdfPtr로 그중 하나를 가리킨다. 레코드 자체가 RayColor의 스택(= 레지스터/로컬 메모리)에 있으니 추가 할당이 0이다. 원서의 "재질이 PDF 객체를 돌려준다"는 다형적 설계는 그대로 유지하면서 할당만 없앤 셈이다.
 대신 이 레코드를 복사하면 안 된다(복사본의 PdfPtr이 원본 내부를 가리킨다). 항상 참조로만 넘긴다.
재질 쪽은 오히려 단순해진다.
// Lambertian — 방향을 뽑지 않고 "코사인 분포로 뽑아 달라"고 PDF만 넘긴다
srec.Attenuation = mTexture->Value(rec.U, rec.V, rec.P);
srec.CosinePdfStorage = CosinePdf(rec.Normal);
srec.PdfPtr = &srec.CosinePdfStorage;
srec.bSkipPdf = false;
return true;
// Metal (Dielectric도 같은 모양)
srec.Attenuation = mAlbedo;
srec.PdfPtr = nullptr;
srec.bSkipPdf = true;
srec.SkipPdfRay = reflectedRay;
C++
복사
정반사 처리
정반사 표면과 법선을 건드리는 인스턴스(회전·이동)는 아직 완전히 정리되지 않았지만, 설계가 깨끗해졌으므로 둘 다 고칠 수 있다. 이 장에서는 우선 정반사만 고친다. 금속과 유전체는 쉽다 — 방향은 이미 계산하고 있으니 그 레이를 SkipPdfRay에 담고 플래그만 세우면 된다(위 코드 블록의 Metal 부분).
 퍼지(fuzz)가 0이 아니면? 엄밀히 말해 그 표면은 더 이상 이상적인 정반사가 아니다. 반사 방향에 무작위 흔들림이 섞이기 때문이다. 그래도 상관없다 — 우리는 이 표면을 "암묵적 샘플링(implicit sampling)"으로 다루기 때문이다. 즉 PDF 계산을 통째로 건너뛰고, 레이를 그냥 그 방향으로 보낸 뒤 감쇠만 곱한다. 1·2권에서 하던 것과 정확히 같은 동작이고, 퍼지가 있든 없든 결과가 맞다.
RayColor는 정반사를 한 줄로 처리한다.
ScatterRecord srec;
if (!rec.MaterialPtr->Scatter(currentRay, rec, srec, randState))
return accumulated;
// 정반사(거울/유리): 밀도로 나눌 수 없는 델타 분포 → 그대로 따라간다.
if (srec.bSkipPdf)
{
throughput = throughput * srec.Attenuation;
currentRay = srec.SkipPdfRay;
continue;
}
C++
복사
우리는 이미 지키고 있었다: 원서는 6장부터 11장까지 금속·유리가 깨진 상태로 진행하다가 여기서 고친다. 우리는 6장에서 "ScatteringPdf가 0이면 감쇠만 곱한다"는 규칙을 먼저 넣어 두었기에 1·2권 장면이 3권 내내 정상으로 렌더됐다. 12장은 그 규칙을 플래그로 명시화한 셈이다.순환 include와 Sampling.h
ScatterRecord가 CosinePdf를 값으로 품으려면 Material.h가 Pdf.h를 include해야 한다(값 멤버는 완전한 타입이 필요하다). 그런데 Pdf.h는 RandomCosineDirection·kPi 때문에 Material.h를 include하고 있었다 — 순환이다.
원서는 pdf.h가 onb.h와 hittable_list.h만 보면 되므로 이 문제를 만나지 않는다. 우리에게 생긴 이유는 방향 생성기들이 원래 Material.h에 있었기 때문이다. 그래서 공통으로 쓰는 것들(π, RandomInUnitSphere, RandomUnitVector, RandomCosineDirection, 이번에 추가한 RandomToSphere)을 Sampling.h 로 빼서 끊었다.
Material.h -> Pdf.h -> Sampling.h (순환 없음)
Plain Text
복사
헤더만 옮긴 기계적인 작업이지만 GPU 코드에서는 특히 중요하다 — 디바이스 함수는 전부 헤더에 인라인으로 들어가므로 include 그래프가 곧 컴파일 단위의 크기이고, 순환은 전방 선언으로 대충 넘길 수도 없다(__device__ 인라인 본문이 필요하다).
구를 향한 샘플링
왜 하필 구인가
방금 만든 알루미늄 상자(아래 결과 참고)는 천장 반사가 눈에 띄게 노이즈하다. 상자 쪽 방향이 더 촘촘히 샘플링되지 않기 때문이다. 그러니 금속 상자의 PDF를 만들면 노이즈가 줄 것이다. 상자를 유리로 바꿔도 마찬가지로 PDF가 필요하다.
문제는 상자의 PDF를 만드는 일이 꽤 성가시고 별로 재미도 없다는 점이다(면 6개 각각에 대해 가시성까지 따져야 한다). 그래서 원서는 방향을 튼다 — 상자 대신 유리 구를 놓고, 구의 PDF를 만든다. 계산이 빠르고 그림도 더 볼 만하다(구 아래 집광이 생긴다).
구 밖에서 구를 균일하게 샘플링하려면
구 밖의 한 점에서 구를 샘플링할 때, 구 표면에서 아무 점이나 고르면 안 된다. 그렇게 하면 뒷면(앞면에 가려 보이지 않는 쪽)을 자주 고르게 되고, 그 방향의 기여는 0이라 샘플을 버리는 셈이 된다.
필요한 것은 "그 점에서 보이는 쪽을 균일하게 덮는" 방법이다. 그리고 한 점에서 구가 차지하는 입체각을 균일하게 샘플링하는 것은, 사실 원뿔을 균일하게 샘플링하는 것과 같다(아래 그림). 원뿔의 축은 레이의 출발점에서 구 중심을 향하고, 옆면은 구에 접한다.
θ 유도
7장에서 방향을 만들 때 쓴 식을 그대로 가져온다. 원뿔 안에서 균일하게 뽑을 것이므로 는 아직 모르는 상수 다.
에 대해 풀면 이다. 이제 를 정한다. 방향이 반드시 안에 들어가도록 분포를 제한하고 있으므로, 0에서 까지의 적분은 1이어야 한다. 즉 일 때 이다.
되돌려 넣으면 , , 사이의 깔끔한 관계가 나온다. 는 7장과 똑같이 로 뽑는다.
θmax 는?
그림에서 바로 읽을 수 있다. 원뿔의 옆면이 구에 접하므로 직각삼각형이 만들어진다.
밀도와 검산
균일 분포이므로 밀도는 입체각의 역수다. 그 입체각은 위에서 나온 와 같은 것인데, 정의대로(단위 구 위의 넓이) 적분해도 같은 값이 나온다.
 극단값으로 검산하기 (원서가 권하는 습관이다)
· 반지름이 0인 구: → 입체각 0. 점은 아무 입체각도 차지하지 않는다.
 · 에 접하는 구(구 표면 바로 위에서 볼 때): → 입체각 . 반구의 넓이가 정확히 다.

그림 12: 구를 감싸는 원뿔
파일: Sampling.h, Sphere.h — 원서 Listing sphere-pdf에 대응// Sampling.h — z축이 구 중심 방향인 좌표계에서 원뿔 안의 방향 하나
__device__ inline Vector3 RandomToSphere(double radius, double distanceSquared, curandState* randState)
{
double r1 = curand_uniform_double(randState);
double r2 = curand_uniform_double(randState);
double cosThetaMax = sqrt(1.0 - radius * radius / distanceSquared);
double z = 1.0 + r2 * (cosThetaMax - 1.0);
double phi = 2.0 * kPi * r1;
double sinTheta = sqrt(fmax(0.0, 1.0 - z * z));
return Vector3(cos(phi) * sinTheta, sin(phi) * sinTheta, z);
}
// Sphere.h
__device__ double PdfValue(const Point3& origin, const Vector3& direction, curandState* randState) const override
{
HitRecord rec;
if (!this->Hit(Ray(origin, direction), 0.001, DBL_MAX, rec, randState))
return 0.0;
double distanceSquared = (mCenter - origin).LengthSquared();
if (distanceSquared <= mRadius * mRadius)
return 0.0; // 구 안에서는 이 공식이 성립하지 않는다
double cosThetaMax = sqrt(1.0 - mRadius * mRadius / distanceSquared);
double solidAngle = 2.0 * kPi * (1.0 - cosThetaMax);
return 1.0 / solidAngle;
}
__device__ Vector3 Random(const Point3& origin, curandState* randState) const override
{
Vector3 direction = mCenter - origin;
Onb uvw(direction); // 8장의 ONB로 방향을 돌린다
return uvw.Transform(RandomToSphere(mRadius, direction.LengthSquared(), randState));
}
C++
복사
CUDA 메모 세 가지
· RandomToSphere에는 루프도 분기도 없다. 난수 두 개로 바로 방향이 나오므로 워프 안 32 레인이 동시에 끝난다. 4장에서 측정한 거절법의 워프 비용(가장 운 나쁜 레인을 기다린다)이 여기서는 아예 발생하지 않는다.
· sqrt(fmax(0.0, 1.0 - z*z))의 fmax는 보험이다. z가 부동소수점 오차로 아주 살짝 1을 넘으면 1 - z*z가 음수가 되고 sqrt가 NaN을 낸다. GPU에서는 그 NaN이 한 픽셀을 통째로 죽인다(아래 NaN 절 참고).
· 우리 Hit은 ConstantMedium 때문에 curandState*를 받는다. 그래서 PdfValue의 시그니처에도 난수 상태가 따라 들어간다 — 원서에는 없는 인자다.구만 샘플링하면?
원서는 여기서 중간 결과를 한 번 보여 준다. 광원 대신 유리 구만 샘플링하면 방 전체는 노이즈가 심하지만 구 아래 집광은 아주 깨끗하게 나온다. 그리고 광원을 샘플링할 때보다 5배 느리다 — 유리에 부딪힌 레이가 반사·굴절로 계속 살아남아 경로가 길어지기 때문이다.
우리는 이 중간 단계를 별도 장면으로 만들지 않고 바로 다음 절(둘 다 샘플링)로 갔지만, "유리가 비싸다"는 관찰은 우리 측정에서도 그대로 확인된다 — 아래 표에서 장면 12(유리 구)는 장면 10(흰 상자)의 2.4배 시간이 걸린다.

이미지 13: 새 PDF로 렌더한 유리 구 코넬 박스 (원서)
광원이 여럿일 때: HittableList도 샘플링 대상
구만 샘플링하면 방이 노이즈하고, 광원만 샘플링하면 집광이 뭉개진다. 답은 뻔하다 — 둘 다 샘플링하면 된다. 그리고 우리는 10장에서 이미 그 도구를 만들었다: 혼합 밀도다.
구현 방법은 두 가지다. RayColor에 hittable 목록을 넘기고 그 안에서 혼합 PDF를 조립하거나, HittableList 자체에 PDF 함수를 붙이거나. 둘 다 잘 동작하지만 원서는 두 번째를 택하고, 우리도 그렇게 했다. 이유는 재귀적으로 잘 맞물리기 때문이다 — HittableList가 Hittable이므로, 목록을 다시 HittablePdf에 넣으면 RayColor는 광원이 하나인지 열 개인지 전혀 신경 쓰지 않아도 된다. MixturePdf는 여전히 2항으로 두고, "여러 광원"이라는 복잡성은 목록 안으로 숨는다.
각 원소를 1/n 확률로 고르므로 밀도는 각 원소 밀도의 평균이다(10장에서 본 혼합 밀도의 n항 버전이다).
파일: HittableList.h — 원서 Listing density-mixture에 대응__device__ double PdfValue(const Point3& origin, const Vector3& direction, curandState* randState) const override
{
double weight = 1.0 / double(mCount);
double sum = 0.0;
for (int i = 0; i < mCount; i++)
sum += weight * mList[i]->PdfValue(origin, direction, randState);
return sum;
}
__device__ Vector3 Random(const Point3& origin, curandState* randState) const override
{
// curand_uniform은 (0,1]이라 그대로 곱하면 mCount가 나올 수 있다 → 마지막 칸으로 클램프
int index = int(curand_uniform(randState) * float(mCount));
if (index >= mCount)
index = mCount - 1;
return mList[index]->Random(origin, randState);
}
C++
복사
(0,1]이 여기서는 함정이다: 3장에서는 curand가 0을 주지 않는 것이 이득이었지만(0으로 나누기 회피), 인덱스를 만들 때는 반대다. 표준적인 int(u * n) 패턴은 u ∈ [0,1)을 전제하는데 curand_uniform은 1.0을 돌려줄 수 있으므로 index == mCount, 즉 배열 범위 밖 접근이 된다. 확률은 아주 낮지만 수억 번 호출되면 반드시 일어나고, GPU에서는 조용히 엉뚱한 메모리를 읽는다. 클램프 한 줄이 그 보험이다.장면 12의 광원 목록은 CreateWorld에서 만든다. 원서는 main()에서 quad lights(...)를 스택에 만들지만, 우리는 디바이스 메모리에 만들어야 하므로 CreateWorld 커널 안에서 new 한다(장면 구축은 커널 1회 실행이라 할당이 문제 되지 않는다). HittableList가 소유(bOwns = true)하므로 FreeWorld가 *lights 하나만 지우면 내부 사각형·구와 배열까지 연쇄 해제된다.
Hittable** lightList = new Hittable*[2];
lightList[0] = new Quad(Point3(213, 554, 227), Vector3(130, 0, 0), Vector3(0, 0, 105), nullptr);
lightList[1] = new Sphere(Point3(190, 90, 190), 90.0, nullptr);
*lights = new HittableList(lightList, 2, true);
C++
복사
재질이 nullptr인 이유: 이 사각형·구는 샘플링 대상일 뿐 장면에 그려지는 물체가 아니다(진짜 물체는 world에 따로 들어 있다). PdfValue/Random은 재질을 보지 않으므로 비워 둔다. 원서도 같은 이유로 empty_material을 넘긴다.NaN 가드
원서 이미지를 자세히 본 독자가 검은 점(specks) 을 지적했다고 한다. 모든 몬테카를로 레이트레이서의 본체는 결국 이 한 줄이다 — pixel_color = average(many many samples).
그래서 샘플 하나가 망가지면 그 픽셀 전체가 죽는다. 렌더에 흰색 또는 검은색 여드름(acne)이 생기고 "나쁜 샘플 하나가 픽셀을 죽인 것 같다"는 느낌이 들면, 그 샘플은 십중팔구 엄청나게 큰 수이거나 NaN이다. 원서 저자는 1천만~1억 레이에 한 번쯤 나온다고 적는다.
여기서 선택지는 둘이다. 근본 원인을 끝까지 추적하거나, NaN을 그냥 죽이고 넘어가거나. 원서는 "부동소수점을 다루는 일은 원래 어렵다"며 후자를 택한다. 우리도 그렇다.
NaN은 자기 자신과 같지 않다는 성질로 걸러 낸다. IEEE 754에서 NaN == NaN은 항상 거짓이므로, x != x가 참이면 그게 NaN이다.
// kernel.cu — PPM 출력 직전
if (col.X() != col.X()) col[0] = 0.0;
if (col.Y() != col.Y()) col[1] = 0.0;
if (col.Z() != col.Z()) col[2] = 0.0;
C++
복사
CUDA에서 위치가 중요하다: 이 검사는 커널 안이 아니라 호스트의 PPM 출력 직전에 둔다. 커널 안에서 하면 수억 번 실행되는 분기가 되고, 워프 발산도 생긴다. 프레임버퍼는 픽셀당 한 번만 읽으므로 거기서 걸러 내는 편이 훨씬 싸다.
컴파일러 최적화 주의: -use_fast_math 계열 옵션을 켜면 컴파일러가 "NaN은 없다"고 가정하고 x != x를 통째로 지워 버릴 수 있다. 우리 프로젝트는 이 옵션을 쓰지 않으므로 안전하다. 켠다면 isnan()을 쓰거나 정수 비트 패턴으로 확인해야 한다.
이미지 15: 여드름 방지 색 함수를 적용한 최종 코넬 박스 (원서)
결과
알루미늄 상자 (장면 11)
키 큰 상자를 금속(Metal(Color(0.8, 0.85, 0.88), 0.0))으로 바꾼다. 정반사가 되살아났는지 확인하는 장면이다.

이미지 12: 임의의 PDF를 쓴 코넬 박스 (원서)
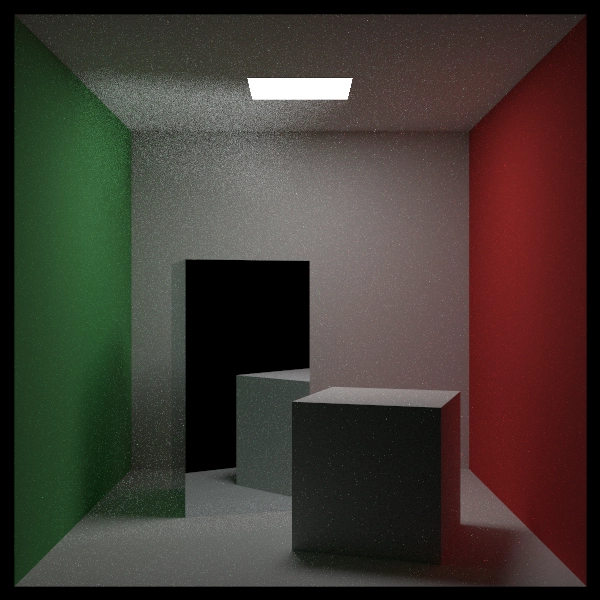
우리 렌더: 알루미늄 상자, 961 spp
거울 상자가 꽤 어둡게 보이는데 이는 정상이다 — 코넬 박스는 카메라 쪽 벽이 없으므로 거울이 그 뚫린 앞면(배경 = 검정) 을 비추기 때문이다. 실제로 상자 영역 픽셀의 47%가 0이 아니고(최댓값 148) 벽·바닥이 비친 부분이 보인다. 원서가 지적한 대로 천장의 반사가 눈에 띄게 노이즈하다(천장 표준편차 45.1 vs 장면 10의 41.4) — 상자 쪽 방향을 더 촘촘히 샘플링하지 않기 때문이다. 이것이 바로 앞 절에서 "구의 PDF를 만들자"로 이어진 동기다.
유리 구 (장면 12)
키 작은 상자를 유리 구로 바꾸고, 광원 목록에 천장 광원과 유리 구를 함께 넣는다.

이미지 14: 유리와 광원 PDF의 혼합 (원서)
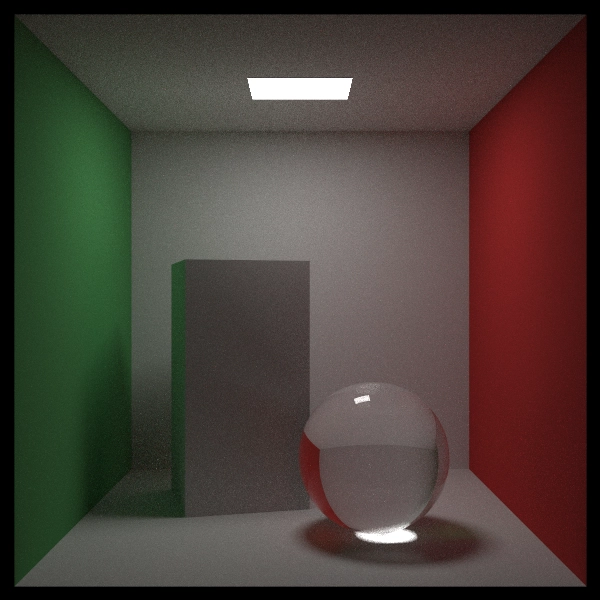
우리 렌더: 유리 구 + 광원 리스트, 961 spp
구 아래의 집광(caustic) 이 또렷하게 잡힌다.
961 spp | 선형 평균 밝기 | 뒷벽 표준편차 | 시간 |
장면 10 (흰 상자 2개) | 0.0764 | 12.57 | 9.9초 |
장면 11 (알루미늄 상자) | 0.0764 | 13.33 | 8.6초 |
장면 12 (유리 구) | 0.0854 | 13.03 | 23.8초 |
유리 구 장면이 2.4배 느린 것은 원서에서도 언급하는 현상이다 — 유리에 부딪힌 레이는 반사·굴절로 계속 살아남아 경로가 길어진다. GPU에서는 이 효과가 더 두드러진다. 워프 안에서 한 레인이라도 유리에 갇혀 있으면 나머지 31개가 함께 기다리기 때문에, 경로 길이의 분산 자체가 비용이 된다.
1·2권 장면 회귀 확인
모든 재질의 Scatter 시그니처를 바꿨으므로 예전 장면들을 다시 렌더해 확인했다.
장면 | 설정 | 결과 |
0 (1권 최종: 구 488개, 금속·유리 포함) | 100 spp, 5.3초 | 정상 — 금속 반사·유리 굴절 모두 그대로 |
8 (코넬 연기: Isotropic 볼륨) | 64 spp, 3.5초 | 정상 — 어두운 연기와 밝은 안개 모두 보임 |
결과 & 검증
•
빌드/실행 확인: VS2022 + CUDA 12.9 Release로 컴파일·링크·실행 성공.
•
정반사 복구: 알루미늄 상자가 방을 비춘다(상자 영역 47%가 0이 아님).
•
구 샘플링: 유리 구 아래 집광이 또렷하고, 광원 목록(사각형 + 구)이 동작한다.
•
회귀: 1·2권 장면(금속/유리/볼륨) 모두 정상.
변경 파일 요약
원서 Listing | 우리 파일 | 메모 |
material-refactor | Material.h | ScatterRecord(PDF 값 저장소와 PdfPtr), Scatter 시그니처 정리 |
lambertian-scatter, isotropic-scatter | Material.h | 방향을 뽑지 않고 PDF만 돌려준다 |
material-scatter | Metal.h, Dielectric.h | bSkipPdf, SkipPdfRay |
ray-color-implicit | kernel.cu (RayColor) | 정반사는 감쇠만 곱하고 그대로 진행 |
sphere-pdf | Sphere.h, Sampling.h | 원뿔 샘플링 RandomToSphere, 구의 밀도 |
density-mixture | HittableList.h | 목록 평균 밀도 / 무작위 선택 |
scene-cornell-al, sampling-sphere | kernel.cu | 장면 11·12, 광원 목록 |
write-color-nan | kernel.cu | NaN 가드 |
— | Sampling.h (신규) | 순환 include 해소 |
CUDA 적용에서 꼭 기억할 3가지
1.
다형성은 쓰되 힙은 쓰지 않는다: PDF를 ScatterRecord 안에 값으로 품고 포인터로 가리키면, 원서의 shared_ptr 설계를 GPU에서 그대로 재현하면서 할당을 0으로 만들 수 있다. 대신 그 레코드를 복사하면 안 된다.
2.
헤더 순환은 공통 도우미를 빼서 끊는다: 디바이스 함수는 전부 헤더에 있으므로 include 그래프가 곧 컴파일 단위이고, 전방 선언으로 우회할 수도 없다.
3.
NaN은 한 픽셀을 통째로 죽인다: 출력 직전에 x != x 로 걸러 주는 세 줄이 값싼 보험이다. 단 fast-math를 켜면 컴파일러가 이 검사를 지워 버릴 수 있다.