



17장 데이터 지역성 (Data Locality)
6부 · 최적화 패턴
더 빠른 하드웨어가 계속 등장하면서 소프트웨어의 성능 고민은 많이 줄었지만, 게임은 사정이 다릅니다. 유저는 언제나 더 풍부하고, 현실적이며, 신나는 플레이 경험을 원합니다. 유저의 관심과 돈을 원하는 게임은 넘쳐나지만, 그중 하드웨어 성능을 가장 잘 끌어내는 게임이 크게 성공하는 경우가 많습니다.
성능 최적화는 소프트웨어 전반을 다루는 깊은 기술입니다. 저수준 프로그래머는 여러 독특한 하드웨어 아키텍처를 꿰고 있습니다. 한편 연구자는 가장 효율적인 알고리즘이 무엇인지 수학적으로 증명하기 위해 경쟁합니다.
이 부에서는 게임 속도를 높이는 데 쓰이는 중간 수준의 패턴을 살펴봅니다. 데이터 지역성(17장)은 컴퓨터의 메모리 계층과 그 활용법을 소개합니다. 더티 플래그(18장)는 불필요한 계산을, 객체 풀(19장)은 불필요한 객체 할당을 피하게 해줍니다. 공간 분할(20장)은 게임 월드 공간 안에서 객체들을 빠르게 배치할 수 있게 해줍니다.
17.1 의도
CPU 캐시를 최대한 활용하도록 데이터를 배치해 메모리 접근 속도를 높입니다.
17.2 동기
지금껏 우리는 속아왔습니다. 해마다 올라가는 CPU 속도 그래프는 무어의 법칙을 단순한 관찰 결과가 아니라 절대불변의 법칙처럼 보여줬습니다. 소프트웨어 개발자는 하드웨어 발전 덕분에 손가락만 빨고 있어도 프로그램이 저절로 빨라지는 것을 보아왔습니다.
요즘은 발전 속도가 더디지만, 칩은 계속 빨라져왔습니다. 그러나 무어의 법칙이 말하지 않은 것이 있습니다. 데이터를 연산하는 속도는 훨씬 빨라졌지만, 데이터를 가져오는 속도는 그만큼 빨라지지 않았습니다.
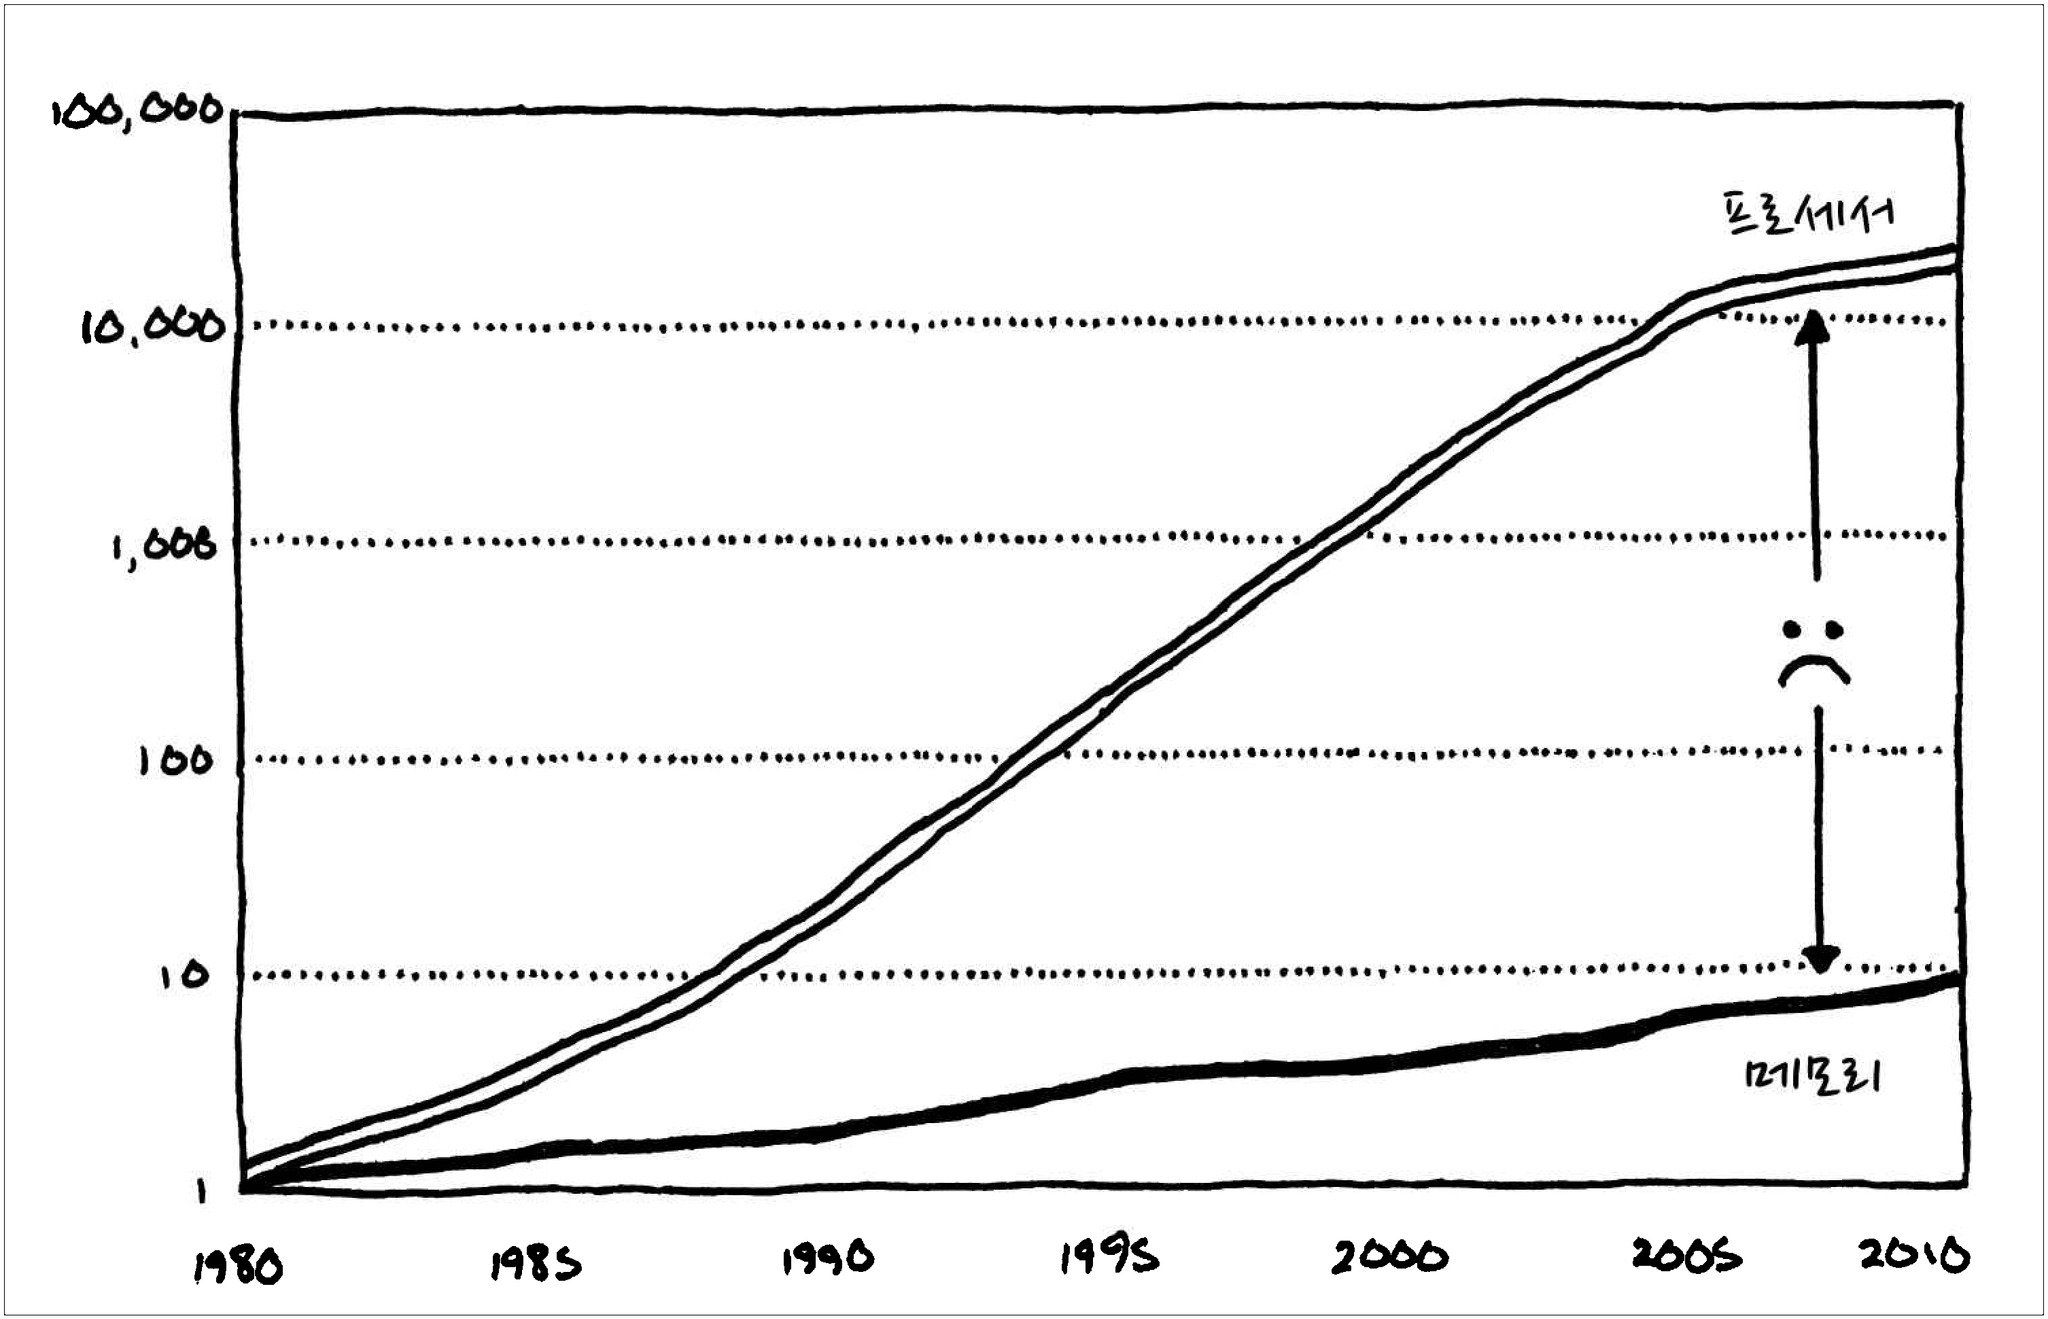
그림 17-1 · 1980년대를 기준으로 본 프로세서와 RAM의 속도 변화
원주 1 CPU 성능은 급격히 증가한 반면 RAM 접근 속도는 훨씬 뒤처집니다. 토니 알브레히트(Tony Albrecht)의 ‘Pitfalls of Object-Oriented Programming’(원문 자료)에서 가져온 그림으로, 『Computer Architecture: A Quantitative Approach』(Morgan Kaufmann, 2011)를 재인용한 것입니다.
초고속 CPU가 수많은 계산을 빠르게 처리하려면 먼저 주메모리의 데이터를 레지스터로 가져와야 합니다. 하지만 그림에서 보듯 RAM은 CPU의 속도를 전혀 따라잡지 못했습니다.
책에서 설명하는 최신 하드웨어에서는 RAM에서 데이터 한 바이트를 가져오는 데 수백 CPU 사이클이 걸립니다. 대부분의 명령어가 데이터를 필요로 한다면, CPU는 왜 시간의 99%를 데이터를 기다리는 데 쓰지 않을까요?
원주 2 RAM은 디스크 드라이브와 달리 이론상 어느 데이터나 같은 시간 안에 접근할 수 있어서 ‘임의접근기억장치(random access memory)’라고 부릅니다. 디스크처럼 순차 읽기를 걱정하지 않아도 됩니다. 적어도 예전에는 그랬습니다. 뒤에서 보겠지만 RAM도 그다지 임의 접근이 가능한 것은 아닙니다.
실제로 CPU는 메모리 응답을 기다리며 많은 시간을 멈춰 있지만, 최악의 상황까지는 아닙니다. 어떤 방법을 쓰는지 조금 긴 비유로 설명해보겠습니다.
데이터 창고
우리가 작은 회사의 회계원이라고 상상해봅시다. 서류로 가득 찬 상자를 받아 숫자를 빽빽하게 써넣는 회계 업무를 합니다. 회계원끼리만 아는 순서에 맞춰 특정 이름표가 붙은 상자를 찾아 작업해야 합니다.
원주 3 잘 모르는 직업을 비유로 들지 말았어야 했는데…….
원래 성실한 데다 카페인 음료까지 마시며 일하므로 서류 한 상자를 처리하는 데 1분이면 됩니다. 진짜 문제는 따로 있습니다. 모든 서류 상자는 다른 건물의 창고에 있습니다. 상자를 가져오려면 창고지기에게 부탁해야 하고, 창고지기는 지게차를 몰고 통로를 다니며 요청받은 상자를 찾습니다.
창고지기가 상자를 찾아 가져오는 데 하루가 꼬박 걸립니다. 우리와 달리 창고지기가 ‘이달의 직원’ 상을 받을 가능성은 앞으로도 전혀 없어 보입니다. 아무리 빨리 일해도 하루에 한 상자만 처리할 수 있습니다. 남은 시간에는 사무실에 앉아 이 지루한 일을 계속해야 할지 고민하는 것밖에 할 수 없습니다.
어느 날 산업 디자이너들이 찾아옵니다. 공장 생산 라인의 속도를 높이듯 작업 효율을 높이는 일을 하는 사람들입니다. 며칠 동안 우리를 관찰한 뒤 다음을 지적합니다.
•
다음에 필요한 상자는 이전 상자와 같은 선반에 있을 가능성이 높습니다.
•
지게차로 상자 하나만 가져오는 것은 어리석습니다.
•
사무실 구석에 작은 공간이 있습니다.
원주 4 방금 사용한 데이터 근처의 데이터를 바로 다음에 사용하는 성질을 참조 지역성(locality of reference)이라고 합니다.
그들은 멋진 해결책을 제안합니다. 상자를 하나 요청할 때 팰릿(pallet) 전체를 가져오게 하라는 것입니다. 필요한 상자뿐 아니라 그 옆의 상자도 모두 가져오게 됩니다. 창고지기는 나머지 상자가 필요한지 모르고, 업무 태도로 보아 신경 쓰지도 않겠지만, 가능한 한 많은 상자를 실은 팰릿 전체를 지게차로 옮깁니다.
원주 5 팰릿은 지게차 등으로 물건을 나를 때 안정적으로 옮기기 위해 사용하는 틀 같은 구조물입니다. — 옮긴이
안전사고 따위는 무시하고 지게차를 건물 안으로 몰아 팰릿을 사무실에 내려놓게 합니다.
새 상자가 필요하면 먼저 사무실의 팰릿에 있는지 확인합니다. 있다면 야호! 1초도 안 걸려 가져와 숫자를 기입할 수 있습니다. 팰릿에 상자가 50개 있고 운 좋게 모두 필요한 상자였다면, 전보다 50배 많은 일을 할 수 있습니다.
원하는 상자가 없으면 이전처럼 하면 됩니다. 사무실에는 팰릿을 하나밖에 둘 수 없으므로, 창고지기는 기존 팰릿을 가져간 뒤 새 팰릿을 가져와야 합니다.
CPU를 위한 팰릿
이 이야기는 CPU의 동작 방식과 비슷합니다. 회계원은 CPU, 책상은 레지스터, 서류 상자는 데이터, 창고는 RAM입니다. 짜증 나는 창고지기는 주메모리에서 레지스터로 데이터를 옮기는 데이터 버스(data bus)에 해당합니다.
30년 전이라면 비유가 여기서 끝났겠지만, CPU의 속도 증가를 RAM이 따라가지 못하면서 하드웨어 개발자들은 다른 해결책을 찾았습니다. 그렇게 나온 것이 CPU 캐시입니다.
CPU 안에는 작은 메모리가 따로 있습니다. 주메모리보다 훨씬 빠르게 데이터를 전달합니다. 칩 안에 들어가야 하기도 하고, 훨씬 빠르지만 비싼 메모리 소자인 정적 RAM(static RAM, SRAM)을 사용하기도 해서 용량은 작습니다.
이 작은 메모리를 캐시, 특히 칩 안의 캐시를 L1 캐시라고 합니다. 비유에서는 팰릿에 해당합니다. 칩이 RAM에서 한 바이트라도 가져와야 하면, RAM은 보통 64~128바이트의 연속된 메모리를 골라 캐시에 복사합니다. 이 메모리 덩어리가 캐시 라인(cache line)입니다.
원주 6 캐시는 L1, L2, L3처럼 여러 계층으로 나뉩니다. 숫자가 커질수록 용량은 커지고 속도는 느려집니다. 이 장에서는 메모리 계층을 따로 다루지 않지만 중요한 내용이므로 알아두세요.
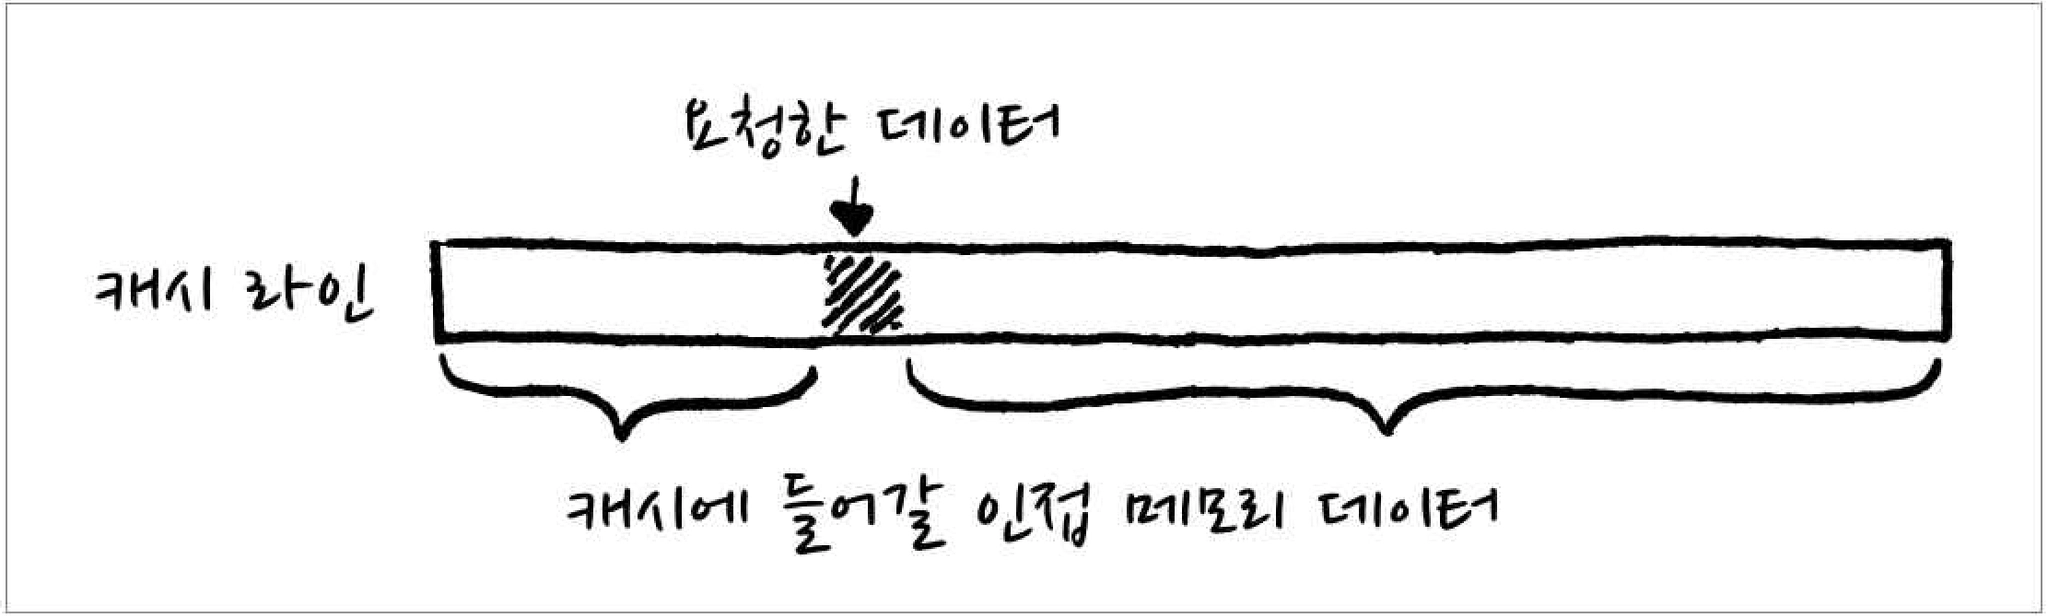
그림 17-2 · 1바이트 데이터와 그 데이터가 들어 있는 캐시 라인
다음에 필요한 데이터가 캐시 라인 안에 있으면 CPU는 RAM보다 훨씬 빠른 캐시에서 바로 가져옵니다. 캐시에서 원하는 데이터를 찾는 것이 캐시 히트(cache hit), 찾지 못해 주메모리에서 가져오는 것이 캐시 미스(cache miss)입니다.
원주 7 비유에서는 한 가지 세부 사항을 대강 넘어갔습니다. 사무실에는 팰릿, 즉 캐시 라인이 하나만 들어갔지만 실제 캐시에는 여러 캐시 라인이 들어갑니다. ‘캐시 집합(cache associativity)’을 검색해보세요.
캐시 미스가 발생하면 CPU는 멈춥니다. 필요한 데이터가 없어서 다음 명령어를 진행할 수 없으므로, 데이터가 도착할 때까지 수백 사이클을 멍하니 기다립니다. 이 대기를 최대한 피해야 합니다. 다음 코드를 최적화한다고 해봅시다.
for (int i = 0; i < NUM_THINGS; i++) {
sleepFor500Cycles();
things[i].doStuff();
}
C++
복사
어디부터 고칠까요? 의미도 없고 비싸기만 한 sleepFor500Cycles()부터 없애야 합니다. 캐시 미스의 성능 비용이 바로 이와 같습니다. 주메모리에서 데이터를 꺼낼 때마다 지연 함수를 코드에 끼워 넣는 것과 다르지 않습니다.
데이터 = 성능?
이 장을 쓰면서 저자는 게임과 비슷한 프로그램을 두 가지로 만들었습니다. 하나는 캐시 라인을 최적으로, 다른 하나는 최악으로 사용했습니다. 캐시를 뒤엎는(thrash) 코드를 벤치마킹해 문제의 크기를 직접 확인하고 싶었습니다.
원주 8 캐시 무효화가 계속 반복되는 현상을 캐시 뒤엎기(cache thrash)라고 합니다. — 옮긴이
결과는 놀라웠습니다. 캐시가 중요하다는 것을 머리로는 알았지만 직접 만들어보니 느낌이 달랐습니다. 두 프로그램은 캐시 미스 횟수만 다르고 하는 일은 완전히 같았는데도 속도가 50배나 차이 났습니다.
원주 9 컴퓨터마다 캐시가 다르므로 저자의 컴퓨터와 여러분의 결과가 다를 수 있습니다. 게임 전용 기기와 PC, 모바일 기기의 결과도 확연히 다를 수 있습니다. 자동차 광고의 표현처럼 ‘실제 연비는 다를 수 있습니다’.
이 실험은 큰 깨달음을 주었습니다. 저자는 이전까지 성능을 데이터가 아닌 코드 측면에서만 생각했습니다. 데이터는 어딘가에 저장된 값일 뿐, 바이트가 느리다거나 빠르다고 말하지는 않으니까요. 하지만 캐시 때문에 데이터를 어디에 두느냐가 성능에 직접 영향을 준다는 것을 알게 되었습니다.
문제는 캐시 이야기를 한 장에 어떻게 담느냐입니다. 캐시 최적화는 아주 큰 주제입니다. 아직 명령어 캐시(instruction cache)는 건드리지도 않았습니다. 코드 역시 메모리에 있으며 실행 전에 CPU로 읽어와야 한다는 점을 잊지 마세요. 전문가라면 캐시만으로 책 한 권을 쓸 수 있을 것입니다.
그래도 자료구조가 성능에 어떻게 영향을 미치는지 길잡이가 될 간단한 기법 몇 가지를 소개하겠습니다.
모든 기법의 결론은 같습니다. 칩이 데이터를 읽을 때 캐시 라인도 함께 읽습니다. 그 안의 값을 더 많이 사용할수록 더 빨라집니다. 처리할 값들이 메모리에서 서로 가까이 있도록 자료구조를 만드는 것이 목표입니다.
원주 12 여기서는 스레드가 하나라고 가정합니다. 여러 스레드가 가까운 데이터를 수정한다면, 코어마다 서로 다른 캐시 라인에 데이터를 두는 편이 빠릅니다. 두 스레드가 같은 캐시 라인의 데이터를 수정하면 두 코어 모두 비싼 캐시 동기화 작업을 해야 합니다. 캐시 일관성 프로토콜(coherence protocol)은 『프로그래머가 몰랐던 멀티코어 CPU 이야기』(한빛미디어, 2010) ‘Story 12’에서 자세히 설명합니다. — 옮긴이
코드가 ‘이것’, ‘저것’, ‘그것’을 순서대로 처리한다면 메모리에도 다음처럼 배치하는 편이 좋습니다.

그림 17-3 · 세 객체가 메모리에 서로 나란히 붙어 있습니다.
‘이것’, ‘저것’, ‘그것’은 포인터가 아니라 실제 객체 데이터입니다. CPU가 ‘이것’을 읽을 때 ‘저것’과 ‘그것’도 함께 가져옵니다. 객체와 캐시 라인의 크기에 따라 차이는 있을 수 있습니다. 다음 객체를 처리할 때 이미 캐시에 값이 있으니 CPU도 우리도 만족할 수 있습니다.

주소 목록과 데이터 배열은 다릅니다 — Thing* things[]가 연속이어도 실제 Thing 객체는 흩어질 수 있습니다. 이 장의 핵심은 반복문이 실제로 읽는 데이터 자체를 가까이 두는 것입니다.
17.3 패턴
CPU에는 메모리 접근 속도를 높이는 캐시가 여러 개 있습니다. 캐시 덕분에 최근에 접근한 메모리 근처의 데이터에 훨씬 빠르게 접근할 수 있습니다. 데이터를 처리하는 순서대로 연속된 메모리에 두어 데이터 지역성을 높이면 캐시를 통해 성능을 높일 수 있습니다.
17.4 언제 쓸 것인가?
다른 최적화처럼 성능 문제가 있을 때 사용해야 합니다. 거의 실행되지 않는 코드에 적용하느라 시간을 낭비하지 마세요. 필요 없는 최적화는 코드만 복잡하게 하고 유연성을 떨어뜨려 삶을 어렵게 만듭니다.
특히 성능 문제의 원인이 캐시 미스인지 확인해야 합니다. 다른 원인이라면 이 패턴이 전혀 도움이 되지 않습니다.
간단한 프로파일링은 두 지점 사이에 타이머 코드를 넣어 경과 시간을 측정합니다. 하지만 캐시 사용량을 확인하려면 더 복잡한 방법이 필요합니다. 캐시 미스가 얼마나, 어디에서 발생하는지 알아야 합니다.
다행히 이를 분석하는 프로파일러가 있습니다. 자료구조를 대대적으로 고치기 전에 먼저 도구를 골라 실행해보고, 도구가 내놓는 복잡한 숫자의 뜻을 이해하는 편이 좋습니다.
원주 13 책에서 소개하는 캐시 미스 측정 프로파일러는 대부분 비쌉니다. 콘솔 게임 개발팀이라면 라이선스가 하나쯤 있을 것입니다. 그렇지 않다면 무료 도구 Cachegrind를 사용해보세요. 가상의 CPU와 캐시 계층 위에서 프로그램을 실행해 모든 캐시 상호작용을 알려줍니다.
캐시 미스가 게임 성능에 영향을 미치는 것은 분명합니다. 미리 최적화하겠다고 많은 시간을 낭비해서는 안 되지만, 개발하는 동안 자료구조를 캐시에 유리하게 만들려고 노력할 필요는 있습니다.
17.5 주의사항
소프트웨어 아키텍처의 전형적인 특징은 추상화입니다. 이 책도 코드를 쉽게 바꾸도록 결합을 줄여주는 패턴에 많은 분량을 할애했습니다. 객체지향 언어에서는 보통 인터페이스로 결합을 줄입니다.
C++에서 인터페이스를 사용하려면 포인터나 레퍼런스로 객체에 접근해야 합니다. 그런데 포인터를 따라 메모리 여기저기를 찾아다니면, 이 패턴으로 피하려던 캐시 미스가 생깁니다.
원주 14 인터페이스를 쓰면 가상 함수 호출도 피할 수 없습니다. CPU가 객체의 vtable에서 실제 함수 포인터를 찾아야 하므로, 여기서 다시 포인터를 추적하다 캐시 미스가 생길 수 있습니다.
데이터 지역성을 위해서는 소중한 추상화 일부를 희생해야 합니다. 지역성에 맞춰 구조를 잡을수록 상속, 인터페이스, 그리고 그 장점을 포기하게 됩니다. 고민하며 절충하는 것 외에 정답은 없습니다. 이런 것이 프로그래밍의 재미입니다!
17.6 예제 코드
데이터 지역성을 최적화하는 힘든 길을 가기로 했다면, CPU가 처리하기 좋게 자료구조를 나눌 방법을 수없이 찾을 수 있습니다. 데이터를 조직하는 일반적인 방법 몇 가지를 예제로 보겠습니다. 게임 코드를 예로 들지만, 다른 패턴과 마찬가지로 이 기법은 적절한 곳 어디에나 적용할 수 있습니다.
연속 배열
많은 개체를 다루는 게임 루프(9장)부터 시작합니다. 각 개체는 컴포넌트 패턴(14장)으로 AI, 물리, 렌더링 분야로 나뉩니다. GameEntity는 다음과 같습니다.
class GameEntity {
public:
GameEntity(AIComponent* ai,
PhysicsComponent* physics,
RenderComponent* render)
: ai_(ai), physics_(physics), render_(render) {}
AIComponent* ai() { return ai_; }
PhysicsComponent* physics() { return physics_; }
RenderComponent* render() { return render_; }
private:
AIComponent* ai_;
PhysicsComponent* physics_;
RenderComponent* render_;
};
C++
복사
각 컴포넌트에는 벡터 몇 개나 행렬 하나 같은 상태, 그리고 이를 갱신하는 메서드가 있습니다. 상세 구현보다는 이런 구조라는 것만 알면 됩니다.
원주 15 이름에서 알 수 있듯 업데이트 메서드 패턴(10장)을 사용합니다. render()도 이름만 다를 뿐 같습니다.
class AIComponent {
public:
void update() { /* 작업 후 상태를 변경한다... */ }
private:
// 목표, 기분 등등...
};
class PhysicsComponent {
public:
void update() { /* 작업 후 상태를 변경한다... */ }
private:
// 강체(rigid body), 속도, 질량 등등...
};
class RenderComponent {
public:
void render() { /* 작업 후 상태를 변경한다... */ }
private:
// 메시, 텍스처, 셰이더 등등...
};
C++
복사
월드의 모든 개체는 큰 포인터 배열 하나로 관리합니다. 게임 루프마다 다음 작업을 합니다.
1.
모든 개체의 AI 컴포넌트를 갱신합니다.
2.
모든 개체의 물리 컴포넌트를 갱신합니다.
3.
렌더링 컴포넌트로 모든 개체를 그립니다.
많은 게임에서 다음처럼 구현합니다.
while (!gameOver) {
// AI를 처리한다.
for (int i = 0; i < numEntities; i++) {
entities[i]->ai()->update();
}
// 물리를 업데이트한다.
for (int i = 0; i < numEntities; i++) {
entities[i]->physics()->update();
}
// 화면에 그린다.
for (int i = 0; i < numEntities; i++) {
entities[i]->render()->render();
}
// 그 외 게임 루프에서 실행해야 할 작업들...
}
C++
복사
CPU 캐시를 모르던 때에는 문제 없어 보였겠지만 이제는 잘못된 점이 보입니다. 단순히 캐시를 뒤엎는 정도가 아니라, 형체도 알아볼 수 없게 두들겨 패는 코드입니다. 무슨 일이 벌어질까요?
원주 16 ‘매질, 몽둥이질’이라는 thrash의 뜻을 이용한 말장난입니다. — 옮긴이
1.
개체를 포인터 배열로 저장해서, 배열 값에 접근할 때 포인터를 따라가며 캐시 미스가 생깁니다.
2.
개체도 컴포넌트를 포인터로 갖고 있어 또 캐시 미스가 생깁니다.
3.
컴포넌트를 갱신합니다.
4.
모든 개체의 모든 컴포넌트에 대해 반복합니다.
더 무서운 점은 이 객체들이 어디에 배치되는지 메모리 관리자만 알고 우리는 모른다는 것입니다. 개체를 할당하고 해제할수록 힙은 점점 어질러집니다.
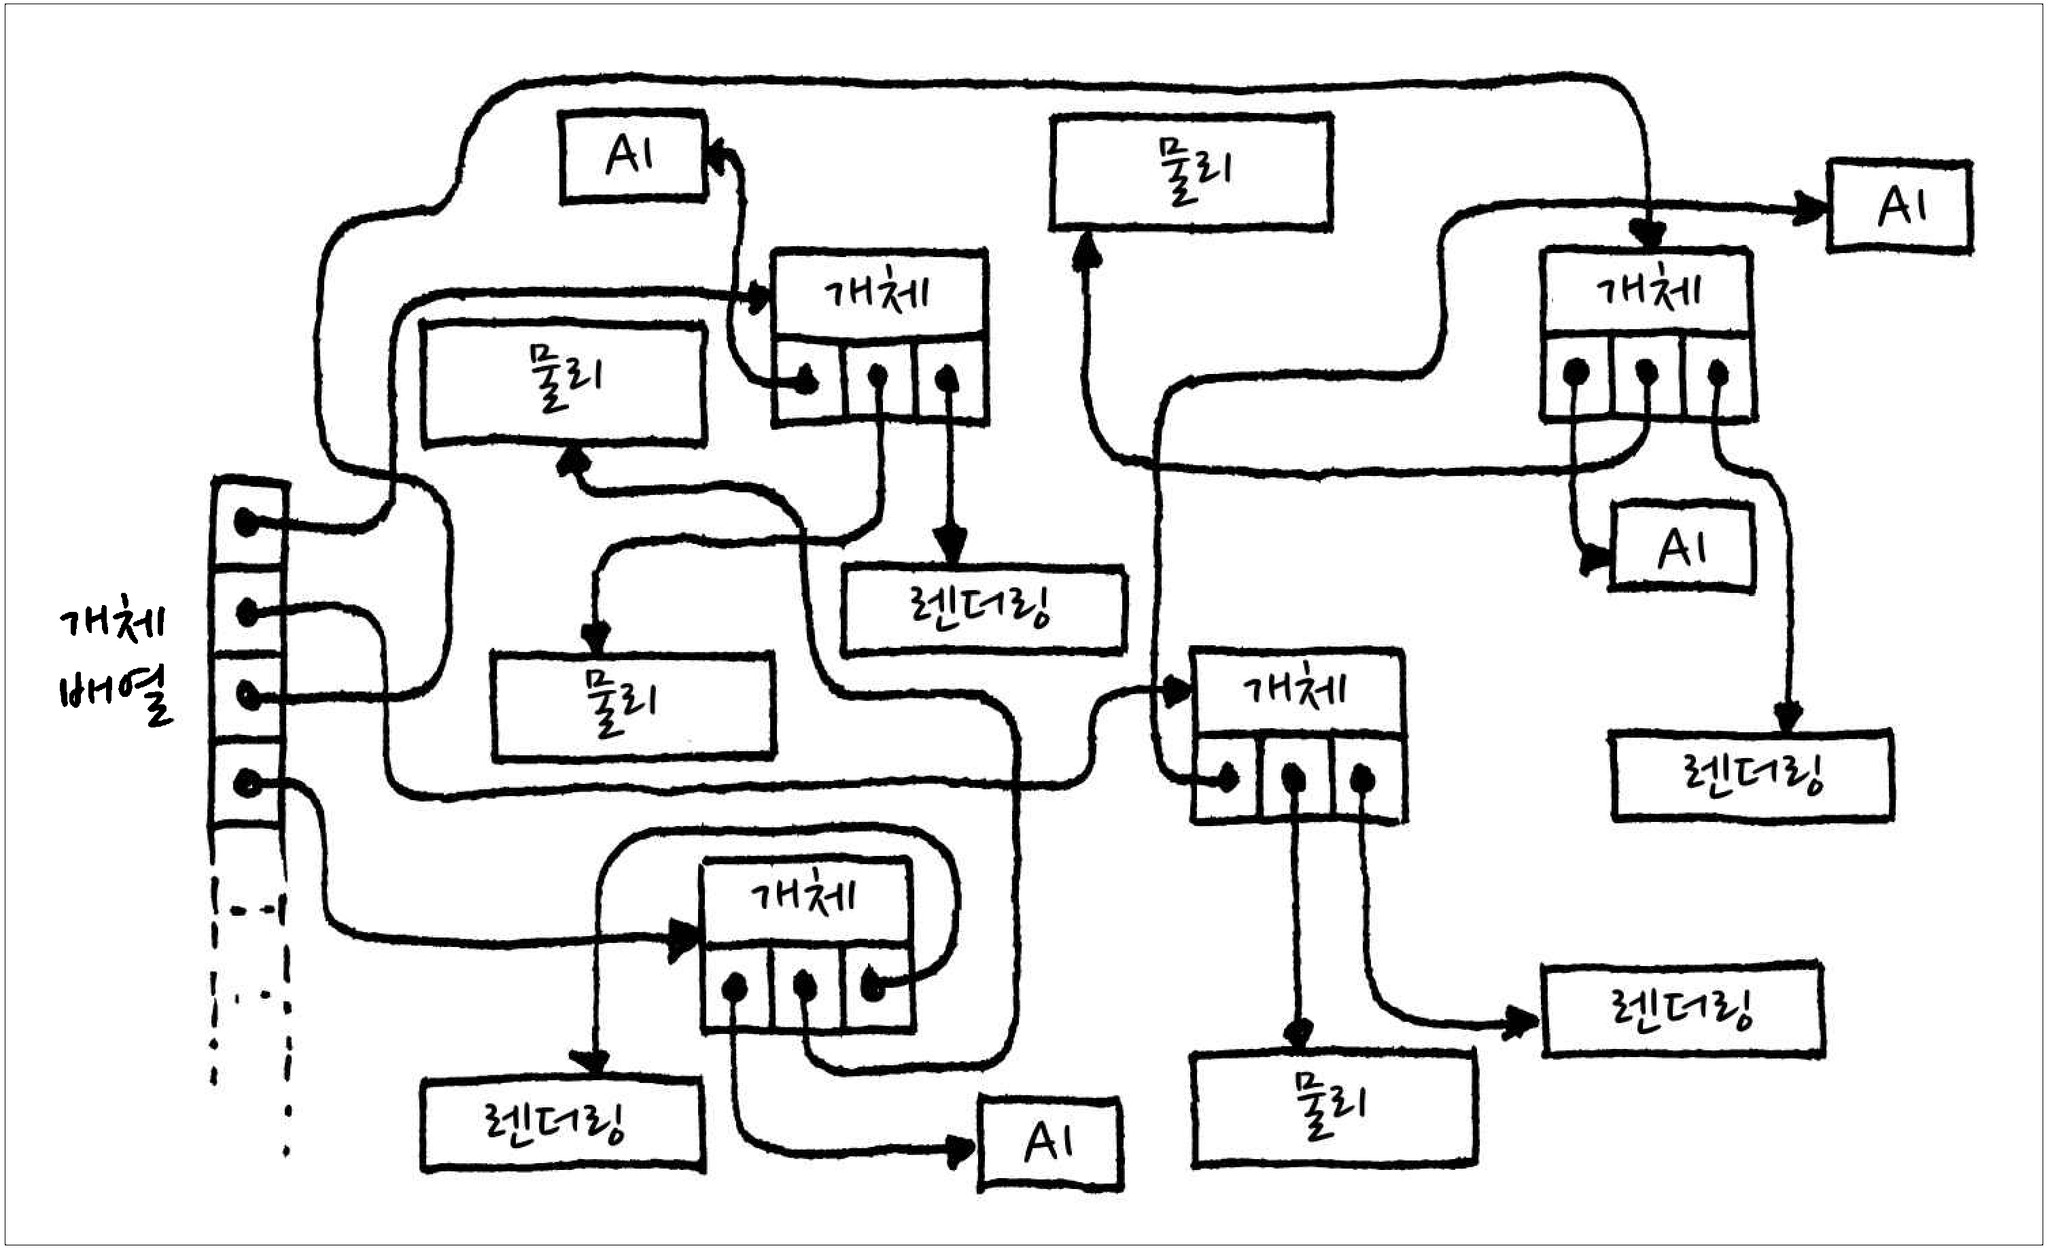
그림 17-4 · 매 프레임 필요한 데이터를 찾으려면 이 화살표를 모두 따라다녀야 합니다.
‘4박 5일 256MB RAM 관광’ 같은 싸구려 패키지여행처럼 주소 공간 여기저기로 끌려다니길 원했다면 이래도 됩니다. 하지만 게임을 빠르게 만들려면 메모리를 어슬렁거리는 것은 좋지 않습니다. 여기저기서 sleepFor500Cycles()를 호출하는 셈입니다.
원주 17 포인터를 따라다니느라 시간을 낭비하는 일을 ‘포인터 추적’이라고 부릅니다. 이름은 멋지지만 실상은 전혀 좋지 않습니다.
개선해봅시다. 게임 개체에 포인터로 접근하는 유일한 이유는, 그 안의 또 다른 포인터로 컴포넌트에 바로 접근하기 위해서입니다. GameEntity에는 흥미로운 상태나 유용한 메서드가 없습니다. 게임 루프에는 컴포넌트만 있으면 됩니다.
캄캄한 주소 공간에 별자리처럼 흩어진 개체와 컴포넌트를 땅으로 끌어내립시다. AI, 물리, 렌더링 컴포넌트 자료형별로 큰 배열을 준비합니다.
원주 18 컴포넌트 패턴에서 그나마 마음에 들지 않는 점은 ‘컴포넌트(component)’라는 단어가 길다는 것입니다.
AIComponent* aiComponents = new AIComponent[MAX_ENTITIES];
PhysicsComponent* physicsComponents = new PhysicsComponent[MAX_ENTITIES];
RenderComponent* renderComponents = new RenderComponent[MAX_ENTITIES];
C++
복사
배열에는 컴포넌트 포인터가 아니라 객체가 들어갑니다. 모든 데이터가 나란히 있으므로 게임 루프가 객체에 바로 접근할 수 있습니다.
원주 19 간접 참조 연산자 ->가 얼마나 줄었는지 보면 개선 정도를 알 수 있습니다. 데이터 지역성을 높이고 싶다면 제거할 수 있는 ->를 찾아보세요.
while (!gameOver) {
// AI를 처리한다.
for (int i = 0; i < numEntities; i++) {
aiComponents[i].update();
}
// 물리를 업데이트한다.
for (int i = 0; i < numEntities; i++) {
physicsComponents[i].update();
}
// 화면에 그린다.
for (int i = 0; i < numEntities; i++) {
renderComponents[i].render();
}
// 그 외 게임 루프에서 실행해야 할 작업들...
}
C++
복사
포인터 추적을 모두 없앴습니다. 메모리를 뒤지는 대신 연속된 세 배열을 쭉 따라갈 수 있습니다.
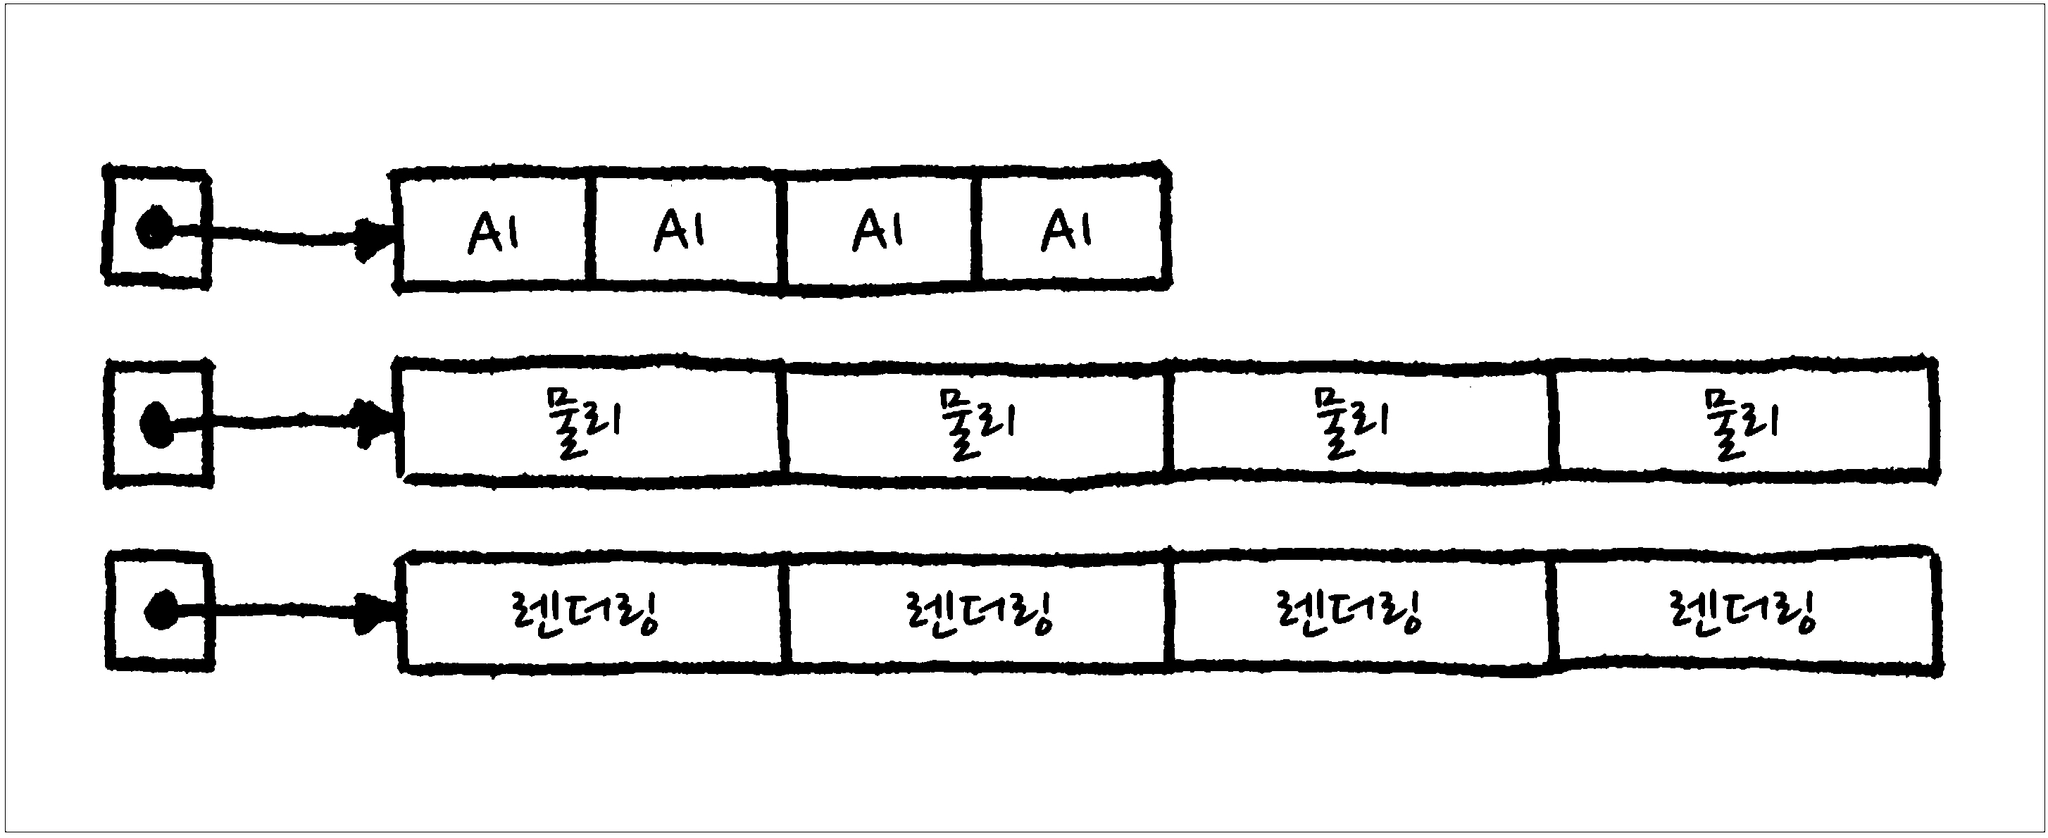
그림 17-5 · 아름답게 이어진 단일 자료형 컴포넌트 배열
바뀐 코드는 연속된 바이트 스트림을 굶주린 CPU에 계속 밀어 넣습니다. 저자의 테스트에서는 업데이트 루프가 50배 빨라졌습니다.
캡슐화를 많이 깨뜨리지 않았다는 점도 흥미롭습니다. 게임 루프가 개체를 거치지 않고 컴포넌트를 직접 갱신하긴 합니다. 하지만 이전에도 AI, 물리, 렌더링 순으로 갱신하려고 entities[i]->ai()->update();처럼 직접 접근했습니다. 컴포넌트는 여전히 자기 데이터와 메서드를 갖고 있어 잘 캡슐화되어 있습니다. 사용하는 방식만 바꾼 것입니다.
GameEntity를 없앨 필요도 없습니다. 각 배열 속 객체를 가리키는 컴포넌트 포인터를 갖게 하면 됩니다. 개념적인 ‘게임 개체’와 그 구성 요소 전체를 하나의 객체로 다른 코드에 전달하는 데 여전히 유용합니다. 성능에 민감한 게임 루프에서만 개체를 우회해 내부 컴포넌트에 직접 접근했다는 것이 핵심입니다.
정렬된 데이터
이번에는 파티클 시스템입니다. 모든 파티클을 하나의 연속된 배열에 놓고 간단한 관리 클래스로 감쌉니다.
원주 20 ParticleSystem은 한 자료형을 위해 별도로 만든 객체 풀(19장)의 일종입니다.
class Particle {
public:
void update() { /* 중력 등등... */ }
// 위치, 속도, 등등...
};
class ParticleSystem {
public:
ParticleSystem() : numParticles_(0) {}
void update();
private:
static const int MAX_PARTICLES = 100000;
int numParticles_;
Particle particles_[MAX_PARTICLES];
};
C++
복사
업데이트 메서드는 다음 기본 작업만 합니다.
void ParticleSystem::update() {
for (int i = 0; i < numParticles_; i++) {
particles_[i].update();
}
}
C++
복사
그런데 매번 모든 파티클을 처리할 필요는 없습니다. 고정 크기의 풀 안에 있는 파티클이 전부 화면에서 반짝거리는 것은 아니니까요. 간단한 해결책은 다음과 같습니다.
for (int i = 0; i < numParticles_; i++) {
if (particles_[i].isActive()) {
particles_[i].update();
}
}
C++
복사
Particle에 사용 중인지를 나타내는 플래그를 두고, 루프에서 모든 파티클의 플래그를 확인합니다. 이 플래그를 읽을 때 나머지 파티클 데이터도 캐시에 올라옵니다. 비활성 파티클이면 다음으로 넘어가므로 함께 읽은 나머지 데이터는 쓸모없어집니다.
원주 21 저수준 프로그래밍에 익숙하다면 또 다른 문제를 보았을 것입니다. 파티클마다 if를 검사하면 분기 예측 실패(branch misprediction)에 따른 파이프라인 지연(pipeline stall)이 생길 수 있습니다. CPU는 하나의 명령을 수행하는 데 여러 클럭을 사용합니다. 계속 일하게 만들려고 명령을 파이프라인으로 나눠 첫 명령이 끝나기 전 다음 명령을 진행합니다.
그러려면 다음에 실행할 명령을 예측해야 합니다. 선형 코드는 쉽지만 흐름 제어가 있으면 어렵습니다. if에서 파티클이 활성이라고 예상해 업데이트 코드를 실행해야 할까요, 비활성이라고 예상해야 할까요?
CPU는 이전 분기 결과를 보고 같은 흐름이 이어질 것이라고 분기 예측합니다. 하지만 활성과 비활성이 계속 섞여 나오면 예측이 실패합니다. 그때 CPU는 추측에 따라 실행하던 명령을 버리고 파이프라인을 비운 뒤(pipeline flush) 다시 시작해야 합니다. 영향은 기기마다 다르지만, 이 때문에 성능에 민감한 코드에서 흐름 제어를 피하려는 개발자도 있습니다.
활성 파티클이 적을수록 메모리를 더 자주 건너뛰고, 실제 파티클을 갱신하기 전에 더 많은 캐시 미스가 발생합니다. 배열이 크고 비활성 파티클이 많으면 다시 캐시 뒤엎기가 일어납니다.
객체를 연속 배열에 놓더라도 실제로 처리할 객체가 연속되어 있지 않으면 큰 도움이 되지 않습니다. 건너뛸 비활성 객체가 어질러져 있으면 이전과 다르지 않습니다.
‘정렬된 데이터’라는 제목이 해결책입니다. 플래그를 검사하는 대신 활성 파티클만 배열 맨 앞에 모읍니다. 앞에 있는 파티클이 활성이라는 것을 알면 검사도 필요 없고, 활성 파티클 수도 쉽게 알 수 있습니다. 루프가 이렇게 아름다워집니다.
for (int i = 0; i < numActive_; i++) {
particles[i].update();
}
C++
복사
아무 데이터도 건너뛰지 않습니다. 캐시에 올라오는 모든 바이트가 처리할 활성 파티클입니다.
매 프레임 배열 전체를 퀵소트하라는 말은 아닙니다. 그러면 득보다 실이 많습니다. 활성 객체가 앞에 모인 상태만 유지하면 됩니다.
배열이 이미 활성과 비활성으로 정리되어 있다고 합시다. 처음에는 모두 비활성이므로 당연히 정리되어 있습니다. 이 상태는 파티클이 활성 또는 비활성으로 바뀔 때만 깨집니다. 둘 다 쉽게 처리할 수 있습니다. 파티클을 활성화할 때는 첫 비활성 파티클과 맞바꿔 활성 영역 맨 뒤로 옮깁니다.
void ParticleSystem::activateParticle(int index) {
// 비활성 상태이어야 함!
assert(index >= numActive_);
// 새로 활성화된 파티클을 비활성 파티클 중 맨 앞에 있는 것과 바꿔서
// 활성 파티클 중에서 맨 뒤에 가게 한다.
Particle temp = particles_[numActive_];
particles_[numActive_] = particles_[index];
particles_[index] = temp;
// 이제 활성 파티클이 하나 늘었다.
numActive_++;
}
C++
복사
원주 22 numActive_와 index가 같다면, 즉 첫 비활성 파티클을 활성화한다면 temp를 이용한 교체는 필요 없습니다. — 옮긴이
비활성화는 반대로 합니다.
void ParticleSystem::deactivateParticle(int index) {
// 활성 파티클이어야 한다!
assert(index < numActive_);
// 파티클이 하나 줄었다.
numActive_--;
// 마지막 활성 파티클과 맞바꿔서
// 비활성 파티클 중에서 맨 앞에 가게 한다.
Particle temp = particles_[numActive_];
particles_[numActive_] = particles_[index];
particles_[index] = temp;
}
C++
복사
저자를 포함해 많은 프로그래머는 객체를 복사해서 메모리 안에서 옮기기를 꺼립니다. 여러 바이트를 옮기는 것이 포인터 하나를 대입하는 것보다 무겁게 느껴지기 때문입니다. 하지만 포인터 추적 비용까지 고려하면 직감이 틀릴 수 있습니다. 캐시를 계속 채워둘 수 있다면 메모리 복사가 더 저렴할 때도 있습니다.
원주 23 다시 강조하지만, 먼저 프로파일링하세요.
활성 상태에 따라 정렬하면 각 파티클의 활성 플래그도 없앨 수 있습니다. 배열 위치와 numActive_로 활성 여부를 알 수 있습니다. 객체가 작아져 한 캐시 라인에 더 많이 들어가므로 속도를 높일 수 있습니다.
모든 것이 만족스럽지는 않습니다. API에서 보듯 객체지향성을 일부 포기해야 합니다. Particle은 자신의 인덱스를 모르므로 activate() 같은 메서드를 스스로 호출해 활성 상태를 바꿀 수 없습니다. 반드시 ParticleSystem을 거쳐야 합니다.
이 예제에서 두 클래스가 강하게 결합되는 것은 괜찮다고 생각합니다. 파티클이라는 하나의 개념이 물리적으로 두 클래스에 나뉜 것뿐입니다. 파티클은 파티클 시스템이라는 맥락 안에서만 의미가 있고, 생성과 소멸도 시스템을 통해서만 가능합니다.
배열의 경계가 곧 상태입니다 — [0, numActive_)가 활성 영역이고 그 뒤가 비활성 영역입니다. 하나를 활성화할 때 전체 정렬 대신 경계의 객체와 한 번만 교환합니다. 이때 외부에서 저장한 인덱스나 포인터가 다른 파티클을 가리키게 될 수 있다는 점은 별도로 관리해야 합니다.
빈번한 코드와 한산한 코드 나누기
간단한 기법으로 캐시를 활용하는 마지막 예제입니다. 게임 개체의 AI 컴포넌트에는 재생 중인 애니메이션, 이동 목표, 에너지 등이 있습니다. 매 프레임 확인하고 바꿔야 하는 값들입니다.
class AIComponent {
public:
void update() { /* ... */ }
private:
Animation* animation_;
double energy_;
Vector goalPos_;
};
C++
복사
반면 사용 빈도가 훨씬 낮은 상태도 있습니다. 산탄총을 쓰는 적을 만나 운 나쁘게 죽었을 때 떨어뜨리는 아이템 정보가 그렇습니다. 이런 드랍 데이터는 개체가 죽을 때 딱 한 번만 사용합니다.
class AIComponent {
public:
void update() { /* ... */ }
private:
// 이전 필드들...
LootType drop_;
int minDrops_;
int maxDrops_;
double chanceOfDrop_;
};
C++
복사
앞서처럼 정렬된 연속 배열을 따라 AI를 갱신한다고 합시다. 아이템 드랍 정보 때문에 컴포넌트가 커져 캐시 라인당 들어가는 수가 줄었습니다. 읽을 전체 데이터가 커져 캐시 미스도 늘어납니다. 업데이트에 쓰지도 않는 드랍 정보를 매 프레임 캐시로 읽게 됩니다.
해결책은 빈번한 데이터와 한산한 데이터를 분리하는 것(hot/cold splitting)입니다. 한쪽에는 매 프레임 필요한 ‘빈번한(hot)’ 데이터와 상태를, 다른 쪽에는 자주 쓰지 않는 ‘한산한(cold)’ 데이터를 모읍니다.
빈번한 데이터는 주 AI 컴포넌트에 둡니다. 자주 쓰므로 포인터를 거치지 않고 바로 읽는 편이 좋습니다. 한산한 데이터는 옆으로 치워두고 필요할 때 접근할 포인터만 빈번한 쪽에 둡니다.
class AIComponent {
public:
// 메서드들...
private:
Animation* animation_;
double energy_;
Vector goalPos_;
LootDrop* loot_;
};
class LootDrop {
friend class AIComponent;
LootType drop_;
int minDrops_;
int maxDrops_;
double chanceOfDrop_;
};
C++
복사
이제 매 프레임 순회할 때 실제로 쓸 데이터만 캐시에 올라옵니다. 한산한 데이터를 가리키는 포인터 하나는 예외로 합시다.
원주 24 빈번한 데이터와 한산한 데이터를 서로 다른 두 배열에 나란히 두면 포인터도 없앨 수 있습니다. 각 배열에서 같은 인덱스를 사용하므로 한산한 AI 데이터를 쉽게 찾을 수 있습니다.
실제로 데이터를 나누는 기준은 애매합니다. 예제에서는 빈번한 것과 한산한 것이 분명하지만 실제 게임에서는 그렇지 않습니다. 어떤 필드는 개체가 특정 모드일 때만, 어떤 데이터는 특정 레벨에서만 쓰입니다.
이런 최적화는 흑마술과 삽질의 중간쯤에 있습니다. 중독되기 쉽고, 데이터를 이리저리 바꾸며 속도 변화를 보다 보면 시간 가는 줄 모릅니다. 어디를 최적화해야 할지 아는 데에는 연습이 필요합니다.
함께 읽는 빈도를 기준으로 나누세요 — ‘AI에 속한 데이터’라는 논리적 분류만 보지 말고, 매 프레임 루프가 실제로 함께 읽는 필드가 무엇인지 보세요. 사망 시 한 번 쓰는 보상 정보는 프레임마다 읽는 위치·에너지와 접근 빈도가 다릅니다.
17.7 디자인 결정
이 패턴의 목적은 메모리 배치가 성능에 큰 영향을 준다는 사고방식을 갖게 하는 것입니다. 구현 방법은 다양합니다. 지역성을 개선하려고 전체 구조를 바꿀 수도 있고 핵심 자료구조 일부에만 적용할 수도 있습니다.
원주 25 노엘 로피스(Noel Llopis)의 유명한 글(원문 자료)은 이를 ‘데이터 중심 디자인(data-oriented design)’이라고 부릅니다. 이 글은 많은 사람이 캐시를 활용하도록 게임을 설계하게 만들었습니다. 김학규 님이 ‘데이터 중심 디자인(혹은 OOP의 위험성)’이라는 제목으로 번역한 글도 있습니다(http://goo.gl/3trNir). — 옮긴이
가장 중요한 질문은 언제 어디에 적용하느냐이지만, 그 밖의 결정도 살펴보겠습니다.
다형성은 어떻게 할 것인가?
지금까지 상속과 가상 함수를 피했고, 정렬된 단일 자료형 배열을 가정했습니다. 즉, 배열 안의 모든 객체 크기가 같았습니다. 하지만 다형성과 동적 디스패치도 유용합니다. 함께 쓸 수는 없을까요?
원주 26 ‘모두 같은 자료형’ 대신 ‘크기가 같다’고 한 것은, 멤버 변수가 추가되지 않은 하위 클래스는 상위 클래스와 크기가 같아 억지로 배열에 넣을 수 있기 때문입니다. 그러나 이런 방법은 절대 권하지 않습니다. — 옮긴이
사용하지 않는다
가장 단순한 방법은 상속하지 않는 것입니다. 최소한 캐시 최적화가 필요한 곳에서만이라도요. 어쨌든 상속을 과용하지 않는 추세이기도 합니다.
원주 27 상속 없이 다형성의 유연함을 얻고 싶다면 타입 객체 패턴(13장)도 방법입니다.
•
안전하고 쉽습니다. 어떤 클래스를 다루는지 정확히 알고 모든 객체 크기가 같습니다.
•
더 빠릅니다. 동적 디스패치는 vtable에서 메서드를 찾고, 포인터를 따라 실제 코드로 이동해야 합니다. 하드웨어에 따라 차이는 있지만 비용이 듭니다.
•
유연하지 않습니다. 동적 디스패치는 객체마다 동작을 다르게 하는 강력한 도구입니다. 개체 종류별로 렌더링, 이동, 공격을 달리할 때 가상 함수는 검증된 해결책입니다. 대신 함수 안에 거대한 다중 선택문을 넣으면 코드가 금방 지저분해집니다.
원주 28 예외도 있습니다. 보통 C++의 가상 메서드 호출에는 한 단계가 더 필요하지만, 컴파일러가 객체의 정확한 자료형을 알면 탈가상화(devirtualization)로 해당 메서드를 정적으로 바로 호출할 수 있습니다. 자바나 자바스크립트의 JIT 컴파일러에서는 더 일반적입니다. GCC 5도 speculative devirtualization, dynamic type detection 등으로 탈가상화를 지원한다고 합니다(https://goo.gl/M10Y25). — 옮긴이
종류별로 다른 배열에 넣는다
어떤 자료형인지 모르는 객체에 특정 행동을 시킬 때 다형성을 사용합니다. 여러 종류를 모아놓고 각자 알아서 일하도록 지시할 수 있습니다. 그런데 꼭 한 컬렉션에 모든 종류를 담아야 할까요? 종류별로 나누면 어떨까요?
•
객체를 빈틈없이 담습니다. 각 배열에는 한 클래스의 객체만 있으므로 패딩이나 다른 이상한 것이 끼어들 틈이 없습니다.
•
정적 디스패치가 가능합니다. 종류를 나눴으므로 다형성 없이 일반적인 비가상 함수를 호출할 수 있습니다.
•
여러 컬렉션을 관리해야 합니다. 종류가 많으면 종류별 배열을 관리하는 부담이 커집니다.
•
모든 자료형을 알아야 합니다. 자료형마다 컬렉션을 두므로 모든 클래스 자료형과 결합됩니다. 다형성의 장점은 확장성(open-ended)입니다. 인터페이스를 사용하는 코드는 그 인터페이스를 구현한 구체 클래스가 아무리 많아도 그들과 결합되지 않습니다.
원주 29 패딩을 언급한 것은 공용체를 이용해 한 클래스 안에 여러 자료형을 저장할 수도 있기 때문입니다. — 옮긴이
하나의 컬렉션에 포인터를 모아놓는다
캐시를 고려하지 않는다면 자연스러운 방식입니다. 배열 하나에 상위 클래스나 인터페이스 포인터를 저장합니다. 다형성을 최대한 활용할 수 있고 어떤 크기의 객체든 포인터로 가리킬 수 있습니다.
•
유연합니다. 정해진 인터페이스를 구현한 객체라면 어떤 종류든 들어와 기존 코드와 상호작용할 수 있습니다.
•
캐시에 유리하지 않습니다. 지금까지 여러 방법을 고민한 이유가 포인터 접근이 캐시에 불리하기 때문입니다. 다만 성능에 민감하지 않은 코드라면 큰 문제가 아닙니다.
게임 개체는 어떻게 정의할 것인가?
컴포넌트 패턴(14장)도 쓴다면, 모든 컴포넌트는 종류별 연속 배열에 있을 것입니다. 게임 루프는 컴포넌트를 직접 순회하므로 개체 자체는 중요하지 않습니다. 그래도 다른 코드에서 개념적인 개체 하나를 나타낼 때에는 여전히 개체 객체가 유용합니다.
그렇다면 개체는 어떻게 표현하고, 컴포넌트는 어떻게 관리해야 할까요?
개체 클래스가 컴포넌트 포인터를 갖는다
첫 예제처럼 GameEntity가 컴포넌트 포인터를 갖는 일반적인 객체지향 방식입니다. 실제 컴포넌트가 메모리 어디에 어떻게 놓였는지는 모릅니다.
•
컴포넌트를 연속 배열에 둘 수 있습니다. 개체는 컴포넌트의 실제 위치에 관심이 없으므로, 정렬된 배열로 순회를 최적화할 수 있습니다.
•
개체에서 컴포넌트를 쉽게 얻습니다. 포인터로 가리키고 있기 때문입니다.
•
컴포넌트를 옮기기 어렵습니다. 활성 상태가 바뀔 때 활성 컴포넌트를 배열 앞에 모으려면 자리를 옮겨야 합니다. 개체의 포인터가 이동 뒤 다른 컴포넌트를 가리키지 않도록 함께 수정해야 합니다.
개체 클래스가 컴포넌트 ID를 갖는다
포인터 때문에 컴포넌트를 옮기기 어렵다면 한 단계 추상화해서 ID나 인덱스로 찾게 할 수 있습니다.
찾는 방법은 자유롭게 정합니다. 컴포넌트마다 유일한 ID를 주고 배열에서 검색해도 되고, ID와 현재 배열 위치를 연결하는 해시 테이블을 써도 됩니다.
•
더 복잡합니다. 아주 복잡하지는 않아도 포인터보다 일이 많습니다. 시스템을 구현하고 디버깅해야 하며 메모리도 더 듭니다.
•
더 느립니다. 검색이나 해싱이 필요하므로 포인터를 직접 따라가는 것보다 느립니다.
•
컴포넌트 관리자에 접근해야 합니다. ID는 추상 식별자이고, 실제 컴포넌트 레퍼런스를 얻으려면 ID를 받아 찾아주는 것이 필요합니다. 컴포넌트 배열을 감싼 클래스가 그 역할을 합니다.
포인터 방식은 개체에서 곧바로 컴포넌트를 얻습니다. 이 방식에는 개체 외에 컴포넌트 등록소(registry)도 필요합니다.
원주 30 ‘싱글턴으로 만들면 간단하지’라고 생각할지도 모르겠습니다. 글쎄요…… 싱글턴 패턴(6장)을 읽고 다시 생각해보세요.
개체가 단순한 ID이다
책에서 소개하는, 일부 게임이 사용하는 최신 방식입니다. 개체의 상태와 동작을 모두 컴포넌트로 옮기면 무엇이 남을까요? 클래스에는 컴포넌트 집합만 남습니다. 이 AI, 저 물리, 그 렌더링 컴포넌트가 하나의 개체라는 것을 정의할 뿐입니다.
컴포넌트가 서로 상호작용해야 하므로 개체는 여전히 필요합니다. 렌더링 컴포넌트는 아마 물리 컴포넌트에 있는 위치를 알아야 합니다. AI가 개체를 움직이려면 물리 컴포넌트에 힘을 적용해야 합니다. 각 컴포넌트는 같은 개체의 형제 컴포넌트에 접근할 수 있어야 합니다.
몇몇 똑똑한 사람들은 이때 ID만 있으면 된다는 것을 깨달았습니다. 개체가 컴포넌트를 아는 대신 컴포넌트가 자기 개체를 알게 합니다. 모든 컴포넌트가 소유 개체의 ID를 기억합니다. AI에서 같은 개체의 물리에 접근하려면 자기와 같은 개체 ID를 가진 물리 컴포넌트를 찾으면 됩니다.
개체 클래스는 사라지고 숫자만으로 컴포넌트를 묶습니다.
•
개체가 단순해집니다. 숫자 하나로 개체 참조를 주고받습니다.
•
개체가 비어 있습니다. 모든 것을 컴포넌트로 옮긴 만큼, 여러 컴포넌트가 공유하는 상태나 동작을 둘 곳도 사라집니다. 컴포넌트 패턴(14장)에 더 집중하게 됩니다.
•
개체 생명주기를 따로 관리하지 않습니다. 개체는 단순한 값이라 별도 메모리 할당·해제가 필요 없습니다. 구성 컴포넌트가 모두 파괴되면 조용히 ‘죽습니다’.
•
특정 개체의 컴포넌트를 찾는 것이 느릴 수 있습니다. 개체가 컴포넌트 ID를 갖는 방식과 같은 문제를 반대 방향으로 만납니다. 개체 ID로 원하는 컴포넌트를 찾는 작업이 비쌀 수 있습니다.
이 검색은 성능에도 민감합니다. 업데이트 중 형제 컴포넌트와 자주 상호작용하기 때문입니다. 한 가지 해결책은 종류별 컴포넌트 배열의 인덱스를 개체 ID로 쓰는 것입니다.
모든 개체가 같은 종류의 컴포넌트를 가진다면 배열을 완전히 병렬로 유지할 수 있습니다. AI 배열의 3번과 물리 배열의 3번이 같은 개체에 속합니다.
그러나 모든 배열을 병렬로 유지해야 하므로 서로 다른 기준으로 정렬하거나 모으기가 어렵습니다. 물리를 쓰지 않거나 화면에 보이지 않는 개체도 있을 수 있습니다. 모든 컴포넌트가 같은 인덱스에 있어야 한다면 물리와 렌더링 배열을 각각 알맞게 정렬할 수 없습니다.
ID와 메모리 위치를 분리하는 이유 — 배열 안의 데이터를 옮겨도 ‘누구인가’를 나타내는 ID는 유지할 수 있습니다. 대신 ID를 현재 위치로 바꾸는 검색 단계와 갱신 책임이 생깁니다. 빠른 순회와 안정적인 개체 참조를 함께 설계하는 문제입니다.
17.8 관련 자료
•
이 장은 컴포넌트 패턴(14장)과 깊이 연결됩니다. 개체를 AI, 물리 같은 분야별로 갱신하므로, 컴포넌트로 나누면 큰 개체를 캐시에 알맞은 크기로 쪼갤 수 있습니다. 캐시 최적화에 가장 널리 쓰이는 자료구조 중 하나입니다. 다만 두 패턴을 반드시 함께 써야 하는 것은 아닙니다. 성능에 민감한 코드가 많은 데이터를 다룬다면 데이터 지역성이 중요합니다.
•
토니 알브레히트의 ‘Pitfalls of Object-Oriented Programming’(원문 자료)은 캐시 최적화에 적합한 자료구조 설계를 소개한 가장 유명한 글일 것입니다. 저자를 포함한 많은 사람이 이 글로 데이터 지역성의 중요성을 알게 되었습니다.
•
비슷한 시기에 노엘 로피스도 영향력 있는 글 ‘Data-Oriented Design (Or Why You Might Be Shooting Yourself in The Foot With OOP)’(원문 자료)을 올렸습니다.
•
이 패턴은 보통 단일 자료형을 연속 배열에 두고 시간이 지나며 객체를 추가·제거합니다. 이런 면에서는 객체 풀 패턴(19장)으로 볼 수도 있습니다.
•