



4부 · 행동 패턴 (Behavioral Patterns)
게임의 무대를 설치하고 배우와 무대장치를 채웠다면 이제 장면(scene)을 시작할 차례입니다. 게임 속 개체에게 할 일을 알려주는 대본, 즉 행동(behavior)이 필요합니다.
물론 모든 코드는 그 자체로 행동이고 모든 소프트웨어는 행동을 정의합니다. 하지만 게임이 구현해야 하는 행동의 폭은 다른 소프트웨어보다 훨씬 넓습니다. 워드 프로세서에도 기능이 많지만, 일반적인 RPG의 수많은 크리처·아이템·퀘스트와는 비교하기 어렵습니다.
이 부의 행동 패턴은 수많은 행동을 유지보수하기 좋은 형태로 빠르게 정의하고 수정하도록 돕습니다. 타입 객체 패턴은 실제 클래스를 정의하지 않고도 행동의 종류를 유연하게 만들게 합니다. 하위 클래스 샌드박스는 다양한 행동을 정의할 때 안전하게 사용할 수 있는 기본 기능 목록을 제공합니다. 바이트코드는 행동을 코드가 아닌 데이터로 정의하는 가장 진보된 방법입니다.
•
11장 · 바이트코드
•
12장 · 하위 클래스 샌드박스
•
13장 · 타입 객체
바이트코드 (Bytecode)
11.1 의도
가상 머신의 명령어를 인코딩한 데이터로 행동을 유연하게 표현합니다.
11.2 동기
게임 개발은 재미있을 수 있지만 쉽지는 않습니다. 요즘 게임을 만들려면 엄청난 양의 복잡한 소스 코드를 구현해야 합니다. 콘솔 제조사나 앱 마켓은 품질을 엄격히 심사하므로 크래시가 한 번만 발생해도 출시가 어려워질 수 있습니다.
동시에 플랫폼의 성능을 최대한 끌어내야 합니다. 게임에서는 다른 소프트웨어보다 성능이 특히 중요합니다. 다른 게임과의 경쟁에서 뒤처지지 않기 위해서도 가차 없이 최적화해야 합니다.
성능과 안정성을 위해 C++ 같은 중량 언어(heavyweight language)를 사용합니다. 이런 언어는 하드웨어를 최대한 활용하는 저수준 표현과, 버그를 막거나 적어도 가두어 두는 풍부한 타입 시스템을 함께 제공합니다.
개발자는 기술력에 자부심을 가지지만 그 비용도 만만치 않습니다. 능숙해지기까지 몇 년간 집중적인 훈련이 필요하고, 그 뒤에도 거대한 코드 규모를 감당해야 합니다. 큰 게임의 빌드 시간은 커피 한 잔을 마실 정도부터, 원두를 볶고 갈고 에스프레소를 추출하고 우유를 데운 뒤 거품에 라테 아트까지 연습할 정도로 길어지기도 합니다.
게임에는 까다로우면서도 가장 중요한 제약이 하나 더 있습니다. 바로 재미입니다. 플레이어는 신선하고 균형이 잘 맞는 게임을 원합니다. 이를 위해 계속 반복 개발해야 합니다. 작은 수정에도 산더미 같은 저수준 코드를 여기저기 고치고 느린 빌드를 멍하니 기다려야 한다면 창조적인 몰입을 유지하기 어렵습니다.
원주 11-1: 저자가 참여한 프로젝트 중에는 C++ 코드만 600만 줄을 넘는 게임도 있었습니다. 화성 탐사차 큐리오시티 로버의 제어 소프트웨어는 그 절반도 되지 않았습니다. 옮긴이는 RAD750 프로세서용 C 코드가 전체 약 250만 줄이라고 설명하며 참고 링크를 덧붙였습니다.
마법 전투!
두 마법사가 한쪽이 이길 때까지 서로 마법을 쓰는 대전 게임을 만든다고 하겠습니다. 마법을 코드로 구현해도 됩니다. 그러나 수정할 때마다 프로그래머가 코드를 고쳐야 합니다. 기획자가 수치만 조금 바꾸어 느낌을 보고 싶어도 게임 전체를 빌드하고 다시 실행해 전투를 해보아야 합니다.
게임은 출시 뒤에도 업데이트로 버그를 고치거나 콘텐츠를 추가할 수 있어야 합니다. 모든 마법이 하드코딩되어 있다면 마법을 고칠 때마다 실행 파일을 패치해야 합니다.
더 나아가 모드(mod)를 지원하고, 사용자가 자신만의 마법을 만들게 하고 싶다면 어떨까요? 마법이 코드라면 모드 개발자도 컴파일러 툴체인을 갖추어야 하고, 개발사는 소스를 공개해야 합니다. 이렇게 만든 마법에 버그가 있으면 다른 플레이어의 게임까지 크래시를 일으킬 수 있습니다.
데이터 > 코드
게임 엔진을 구현한 언어는 마법을 만들기에 적합하지 않습니다. 마법 기능을 핵심 코드로부터 안전하게 격리해야 합니다. 쉽게 고치고 다시 불러오며, 나머지 게임 실행 파일과 물리적으로 분리할 수 있으면 좋겠습니다.
바로 데이터가 그렇습니다. 행동을 별도의 데이터 파일로 정의하고 게임 코드가 읽어서 ‘실행’할 수 있다면 앞의 목표를 모두 달성할 수 있습니다.
그런데 데이터를 실행한다는 것은 무슨 뜻일까요? 파일 속 바이트로 행동을 어떻게 표현할까요? 몇 가지 방법이 있습니다. 먼저 인터프리터 패턴과 비교하여 바이트코드의 장단점을 알아보겠습니다.
인터프리터 패턴
인터프리터 패턴만으로 한 장을 쓸 수도 있지만 『GoF의 디자인 패턴』에 있으므로 여기서는 간단히 소개하겠습니다. 실행하려는 언어가 다음과 같은 수식을 지원한다고 합시다.
(1 + 2) * (3 - 4)
Plain Text
복사
표현식을 읽어 언어의 문법에 따라 각각을 객체로 바꿉니다. 숫자 리터럴은 각자 하나의 객체가 됩니다.

그림 11-1. 숫자 리터럴 네 개가 순서대로 놓여 있습니다
숫자 상수는 값을 감싼 단순한 객체입니다. 연산자도 객체로 바꾸되 피연산자를 참조하게 합니다. 괄호와 우선순위까지 반영하면 작은 객체 트리가 만들어집니다.
원주 11-2 · 옮긴이: 『GoF의 디자인 패턴』에서는 ‘해석자 패턴’으로 번역했습니다(324쪽).
원주 11-3: 이 마법의 정체는 파싱(parsing)입니다. 파서는 문자열을 읽고 문법 구조를 나타내는 객체 집합인 추상 구문 트리를 만듭니다. 이런 기능을 조금이라도 만들었다면 컴파일러의 일부를 만든 셈입니다.

그림 11-2. 추상 구문 트리로 만든 중첩 표현식
인터프리터 패턴의 목적은 추상 구문 트리를 만드는 데서 끝나지 않습니다. 이를 실행해야 합니다. 원리는 기발합니다. 표현식과 하위 표현식으로 트리를 만든 뒤, 객체지향답게 각 표현식이 자신을 평가하게 합니다.
먼저 모든 표현식 객체가 상속할 인터페이스를 만듭니다.
class Expression {
public:
virtual ~Expression() {}
virtual double evaluate() = 0;
};
C++
복사
언어가 지원하는 표현식마다 Expression을 상속하는 클래스를 정의합니다. 가장 간단한 숫자부터 보겠습니다.
class NumberExpression : public Expression {
public:
NumberExpression(double value) : value_(value) {}
virtual double evaluate() { return value_; }
private:
double value_;
};
C++
복사
숫자 리터럴은 자신의 값으로 평가(evaluate)됩니다. 덧셈이나 곱셈은 하위 표현식을 포함하므로 조금 더 복잡합니다. 자신을 평가하기 전에 포함된 하위 표현식을 재귀적으로 평가합니다.
class AdditionExpression : public Expression {
public:
AdditionExpression(Expression* left, Expression* right)
: left_(left), right_(right) {}
virtual double evaluate() {
// 피연산자를 실행합니다.
double left = left_->evaluate();
double right = right_->evaluate();
// 피연산자를 더합니다.
return left + right;
}
private:
Expression* left_;
Expression* right_;
};
C++
복사
간단한 클래스 몇 개로 복잡한 수식도 자유롭게 표현하고 평가할 수 있습니다. 필요한 만큼 객체를 만들고 알맞게 연결하기만 하면 됩니다.
아름답고 단순한 패턴이지만 문제도 있습니다. 그림에는 작은 상자와 이를 연결하는 화살표가 많습니다. 코드가 작은 객체로 이루어진 복잡한 프랙털 트리가 되므로 다음과 같은 단점이 있습니다.
•
코드를 불러올 때 작은 객체를 대량으로 만들고 연결해야 합니다.
•
객체와 연결 포인터가 많은 메모리를 차지합니다. 앞의 단순한 수식도 32비트 CPU에서 패딩을 제외하고 최소 68바이트가 필요합니다.
•
포인터를 따라 하위 표현식으로 이동하므로 데이터 캐시에 좋지 않습니다. 가상 메서드 호출은 명령어 캐시(instruction cache)에도 좋지 않습니다.
결론은 매우 느리다는 것입니다. 느리고 메모리도 많이 필요하므로 널리 사용되는 언어 대부분은 실행 방식으로 이 인터프리터 패턴을 사용하지 않습니다.
원주 11-4: 곱셈 구현도 비슷하므로 직접 만들 수 있을 것입니다.
원주 11-5: 루비는 15년 동안 이 인터프리터 방식으로 동작하다가 1.9에서 이 장의 바이트코드 방식으로 바뀌었습니다. 여러분은 이 책 덕분에 많은 시간을 아끼는 셈입니다.
원주 11-6: 저런, 여기에 vtable 포인터도 있을 수 있습니다.
원주 11-7: 캐시의 의미와 성능에 미치는 영향은 17장의 데이터 지역성 패턴을 참고하세요.
가상 기계어
일반적인 게임이 실행될 때 컴퓨터는 C++ 문법 트리를 순회하지 않습니다. 미리 컴파일한 기계어(machine code)를 실행합니다. 그 장점은 다음과 같습니다.
•
밀도가 높습니다. 이진 데이터가 연속해서 꽉 차 있으므로 비트를 낭비하지 않습니다.
•
선형적입니다. 명령어가 모여 있고 순서대로 실행됩니다. 흐름 제어를 제외하면 메모리를 여기저기 넘나들지 않습니다.
•
저수준입니다. 각 명령은 비교적 작은 작업을 합니다. 이를 조합해 흥미로운 행동을 만듭니다.
•
빠릅니다. 앞의 이유에 더해 하드웨어가 직접 실행하므로 매우 빠릅니다.
그렇다고 마법을 실제 기계어로 만들고 싶지는 않습니다. 사용자가 제공한 기계어를 게임에서 실행하게 하는 것은 해커에게 공격해 달라고 하는 셈입니다. 기계어의 성능과 인터프리터 패턴의 안전성 사이에서 절충해야 합니다.
실제 기계어 대신 우리만의 가상 기계어를 정의하고, 이를 실행하는 작은 에뮬레이터를 만들면 어떨까요? 실제 기계어처럼 밀도가 높고 선형적이며 비교적 저수준이지만, 게임이 완전히 통제하므로 안전하게 격리할 수 있습니다.
이 에뮬레이터를 가상 머신(virtual machine, VM), VM이 실행하는 가상의 이진 기계어를 바이트코드(bytecode)라고 부르겠습니다. 유연하고 여러 행동을 데이터로 쉽게 정의할 수 있으며, 인터프리터 패턴 같은 고수준 형식보다 성능도 좋습니다.
막막하게 들릴 수 있지만, 기능을 제한하면 도전해 볼 만하다는 것을 이 장에서 보여드리겠습니다. 직접 구현할 일이 없더라도 루아처럼 바이트코드로 구현한 언어를 더 잘 이해하게 될 것입니다.
원주 11-8: 책에서는 이 이유로 많은 콘솔과 iOS가 로드하거나 실행 중 생성한 기계어를 앱에서 실행하지 못하게 한다고 설명합니다. 옮긴이는 심사 때 확인하지 못한 코드를 실행할 수 있기 때문이라고 덧붙이며, 당시의 ‘iOS Developer Program License Agreement’ 3.3.2, Xamarin의 ‘iOS > Advanced Topics > Limitations’ 중 ‘No Dynamic Code Generation’, LuaJIT 설치 문서의 ‘Cross-compiling for consoles’를 참고 자료로 들었습니다. 저자는 이를 안타깝게 여깁니다. 빠른 언어의 JIT 컴파일러가 바로 실행 중 코드를 최적화된 기계어로 바꾸는 방식을 사용하기 때문입니다.
원주 11-9: 프로그래밍에서는 ‘가상 머신’과 ‘인터프리터’를 같은 뜻으로 쓰기도 합니다. 이 책도 둘을 번갈아 사용합니다. GoF의 인터프리터 패턴을 말할 때에는 구분을 위해 ‘패턴’을 붙입니다.

어디까지가 데이터일까요? 체력 = 100처럼 값만 저장하면 설정 데이터입니다. 현재 체력을 읽고 → 민첩성과 지혜를 더하고 → 2로 나누고 → 체력에 더한다처럼 실행 순서까지 데이터로 저장하면 행동을 표현할 수 있습니다. 이를 실제 게임 API 호출로 바꾸는 프로그램이 VM입니다. 플랫폼 정책이나 특정 언어 버전 관련 원주는 책이 쓰인 당시의 설명으로 읽으면 됩니다.
11.3 패턴
명령어 집합은 실행 가능한 저수준 작업을 정의합니다. 명령어를 바이트의 나열로 인코딩합니다. 가상 머신은 중간 값을 스택에 저장하면서 명령어를 하나씩 실행합니다. 명령어를 조합하여 복잡한 고수준 행동을 정의할 수 있습니다.
11.4 언제 쓸 것인가?
이 책에서 가장 복잡하고 적용도 쉽지 않은 패턴입니다. 정의할 행동은 많은데 다음 이유로 게임 구현 언어를 그대로 쓰기 어렵다면 고려합니다.
•
언어가 너무 저수준이어서 작업량이 많거나 오류를 일으키기 쉽습니다.
•
컴파일 시간이나 빌드 환경 때문에 반복 개발이 오래 걸립니다.
•
보안에 취약합니다. 새 행동이 게임을 망가뜨리지 않게 나머지 코드와 격리해야 합니다.
대부분의 게임이 여기에 해당합니다. 모두 빠른 반복 개발과 안전성을 원합니다. 다만 공짜로 얻지는 못합니다. 바이트코드는 네이티브 코드보다 느리므로 성능에 민감한 부분에는 적합하지 않습니다.
11.5 주의사항
나만의 언어나 시스템 속의 또 다른 시스템을 만드는 데에는 묘한 매력이 있습니다. 책의 예제는 아주 단순하게 만들겠지만 실제 적용 과정에서는 규모가 커지기 쉽습니다.
언어나 스크립트 시스템을 처음 만들 때는 간단할 것이라 생각합니다. 하지만 필요한 기능을 계속 붙이다 보면 어느새 완전한 언어가 됩니다. 되는 대로 유기적으로 자라나서 ‘판자촌에서나 볼 법한 구조적 우아함’을 갖게 된다는 점만 빼면 말입니다.
완전한 언어를 만드는 것이 잘못은 아닙니다. 되는 대로 만들지 말라는 뜻입니다. 적어도 바이트코드가 표현할 범위는 꼼꼼히 관리해야 합니다. 고삐 풀린 망아지가 되지 않도록 줄을 단단히 잡아야 합니다.
원주 11-10: 저자에게 게임 개발이 매력적인 것도 같은 이유입니다. 언어든 게임이든 다른 사람이 즐겁게 창의력을 발휘할 가상 공간을 만들려고 노력합니다.
원주 11-11: Mustache, 루비의 Liquid, 자바스크립트의 Handlebars, 파이썬의 Jinja 같은 템플릿 언어도 대부분 이런 과정을 거쳤습니다.
프론트엔드가 필요합니다
저수준 명령어는 성능 면에서 좋지만 사용자가 이진 바이트코드를 직접 작성할 수는 없습니다. 행동을 코드 밖으로 꺼낸 목적은 고수준으로 표현하기 위해서였습니다. C++가 너무 저수준이라고 해놓고 우리가 만든 어셈블리 언어를 쓰게 한다면 개선이 아닙니다.
GoF의 인터프리터 패턴 설명과 마찬가지로, 여기서는 바이트코드를 생성할 방법이 있다고 가정합니다. 보통 사용자가 고수준 형식으로 행동을 작성하면 도구가 VM용 바이트코드로 변환합니다. 이 도구가 컴파일러입니다.
컴파일러라는 말이 얼마나 무섭게 들리는지 압니다. 그래서 미리 말씀드립니다. 저작 도구를 만들 여유가 없다면 이 패턴을 쓰기 어렵습니다. 그래도 조금 더 읽으면 생각만큼 어렵지 않다는 것을 알게 될 것입니다.
원주 11-12: 예외적으로 1992년 게임 《로보워(RoboWar)》에서는 로봇을 조종하기 위해 어셈블리와 매우 비슷한 언어와 이 장 같은 명령어 집합으로 프로그램을 작성했습니다. 저자가 어셈블리 같은 언어를 처음 접한 게임입니다.
디버거가 그리워집니다
프로그래밍은 어렵습니다. 기계에게 시키고 싶은 일은 알아도 언제나 정확하게 표현하지는 못하므로 버그가 생깁니다. 무엇이 잘못되었고 어떻게 고칠지 도와주는 디버거, 정적 분석기, 디컴파일러 같은 도구가 많습니다. 그러나 이들은 기존의 어셈블리나 고수준 언어를 대상으로 만들어졌습니다.
직접 만든 VM에서는 이런 도구가 그대로 통하지 않습니다. VM 구현에 중단점을 걸어 내부를 볼 수는 있지만, 그것은 VM 자체가 하는 일입니다. 바이트코드가 어느 고수준 행동에 해당하며 지금 어디까지 진행했는지를 직접 보여주지는 않습니다. 컴파일 전의 형태로 추적할 수 없는 것입니다.
행동이 단순하면 디버깅 도구 없이도 버틸 수 있습니다. 하지만 콘텐츠가 커지면 바이트코드가 무엇을 하는지 보여주는 기능에 시간을 투자해야 합니다. 이 기능이 게임에 포함되어 출시되지 않을 수는 있어도, 출시까지 가는 데 매우 중요합니다.
원주 11-13: 모드를 지원한다면 디버깅 기능도 함께 제공해야 하므로 중요성은 더 말할 필요가 없습니다.
11.6 예제 코드
예제를 보면 생각보다 구현이 쉽다고 느낄 수도 있습니다. 먼저 VM의 명령어 집합을 정의하겠습니다. 바이트코드를 생각하기 전에 우리가 API를 만든다고 생각해 보세요.
마법의 API
마법을 C++로 구현한다면 어떤 API가 필요할까요? 게임에서 어떤 기본 연산이 필요할까요? 마법은 대개 마법사의 스탯을 바꾸므로 다음부터 시작합니다.
void setHealth(int wizard, int amount);
void setWisdom(int wizard, int amount);
void setAgility(int wizard, int amount);
C++
복사
첫 매개변수 wizard는 대상입니다. 0이면 우리 마법사, 1이면 상대 마법사입니다. 회복 마법으로 우리 체력을 회복하거나 상대 체력을 깎을 수 있습니다. 이 세 함수만으로도 다양한 효과를 만들 수 있습니다.
하지만 조용히 수치만 바뀌면 게임 로직은 괜찮아도 플레이어는 심심합니다. 조금 더 추가하겠습니다.
void playSound(int soundId);
void spawnParticles(int particleType);
C++
복사
소리와 파티클은 게임 규칙에는 영향을 주지 않지만 긴장감을 높입니다. 카메라 흔들기나 애니메이션도 가능하겠지만 우선 이것으로 시작합니다.
마법 명령어 집합
이 API를 데이터에서 제어하도록 바꾸겠습니다. 작게 시작해 단계적으로 확장합니다. 우선 매개변수를 전부 제거합니다. set...() 함수는 언제나 우리 마법사의 스탯을 최댓값으로 만듭니다. 효과도 하드코딩한 한 종류의 사운드와 파티클만 재생합니다.
이제 마법은 단순한 명령어 집합입니다. 각 명령은 할 일을 나타내며 열거형으로 표현할 수 있습니다.
enum Instruction {
INST_SET_HEALTH = 0x00,
INST_SET_WISDOM = 0x01,
INST_SET_AGILITY = 0x02,
INST_PLAY_SOUND = 0x03,
INST_SPAWN_PARTICLES = 0x04
};
C++
복사
마법을 데이터로 인코딩하려면 열거형 값을 배열에 넣습니다. 원시명령(primitive)이 몇 개 없으므로 한 바이트로 모두 나타낼 수 있습니다. 마법 코드가 실제로 바이트의 목록이므로 바이트코드라고 부릅니다.
명령 하나를 실행할 때는 어느 원시명령인지 확인하고 대응하는 API를 호출합니다.
switch (instruction) {
case INST_SET_HEALTH:
setHealth(0, 100);
break;
case INST_SET_WISDOM:
setWisdom(0, 100);
break;
case INST_SET_AGILITY:
setAgility(0, 100);
break;
case INST_PLAY_SOUND:
playSound(SOUND_BANG);
break;
case INST_SPAWN_PARTICLES:
spawnParticles(PARTICLE_FLAME);
break;
}
C++
복사
인터프리터는 이렇게 데이터와 코드를 연결합니다. 전체 마법을 실행하는 VM에서는 이 코드를 다음과 같이 감쌉니다.
원주 11-14: 어떤 VM은 한 명령을 두 바이트 이상으로 표현하고 더 복잡하게 디코딩합니다. x86 같은 실제 기계어도 매우 복잡합니다. 책에서는 자바 VM과 .NET의 공통 언어 런타임(CLR)도 한 바이트를 중심으로 표현하므로 이 예제에도 충분하다고 설명합니다. 옮긴이는 2015년 기준으로 자바 바이트코드 256개 중 198개가 사용되고 51개가 예약되어 있으며, .NET CIL에는 두 바이트인 opcode도 있다고 덧붙였습니다.
class VM {
public:
void interpret(char bytecode[], int size) {
for (int i = 0; i < size; i++) {
char instruction = bytecode[i];
switch (instruction) {
// 각 명령별 case문이 들어갑니다...
}
}
}
};
C++
복사
첫 VM이 완성되었습니다. 하지만 아직 유연하지 않습니다. 상대 마법사를 대상으로 하거나 스탯을 낮출 수 없고, 소리도 한 종류뿐입니다. 실제 언어처럼 표현하려면 매개변수를 받아야 합니다.
스택 머신
복잡한 중첩식을 계산하려면 가장 안쪽 하위 표현식부터 계산하고, 그 결과를 바깥 표현식의 인수로 넘깁니다. 전체 계산이 끝날 때까지 반복합니다.
인터프리터 패턴은 이를 중첩 객체 트리로 직접 나타냈습니다. 성능을 위해 명령을 일차원으로 늘어놓더라도 하위 표현식 결과를 올바른 중첩 순서로 전달해야 합니다. 이를 위해 CPU처럼 스택을 사용합니다.
class VM {
public:
VM() : stackSize_(0) {}
// 그 외...
private:
static const int MAX_STACK = 128;
int stackSize_;
int stack_[MAX_STACK];
};
C++
복사
VM에 값 스택이 생겼습니다. 예제의 명령은 숫자만 받으므로 int 배열이면 됩니다. 명령끼리 이 스택으로 데이터를 주고받습니다. 값을 넣는 push()와 꺼내는 pop()을 추가하겠습니다.
원주 11-15: 이런 구조를 스택 머신이라고 합니다. Forth, PostScript, Factor는 사용자가 스택에 직접 접근하게 합니다. 옮긴이는 이런 언어를 스택 기반 언어라고 설명합니다. C++에서는 컴파일러가 함수 인수의 전달을 처리하지만, 스택 기반 언어는 코드에서 직접 스택에 값을 넣어 함수에 인수를 전달합니다.
class VM {
private:
void push(int value) {
// 스택 오버플로를 검사합니다.
assert(stackSize_ < MAX_STACK);
stack_[stackSize_++] = value;
}
int pop() {
// 스택이 비어 있지 않은지 확인합니다.
assert(stackSize_ > 0);
return stack_[--stackSize_];
}
// 그 외...
};
C++
복사
명령이 매개변수를 받을 때는 스택에서 꺼내 옵니다.
switch (instruction) {
case INST_SET_HEALTH: {
int amount = pop();
int wizard = pop();
setHealth(wizard, amount);
break;
}
case INST_SET_WISDOM:
case INST_SET_AGILITY:
// 위와 같은 식으로...
case INST_PLAY_SOUND:
playSound(pop());
break;
case INST_SPAWN_PARTICLES:
spawnParticles(pop());
break;
}
C++
복사
스택에서 값을 꺼내려면 먼저 넣는 방법이 필요합니다. 정숫값을 나타내는 리터럴 명령어를 만들겠습니다. 그런데 리터럴은 값을 어디서 얻을까요? ‘밑바닥까지 전부 거북이’ 같은 무한 회귀를 어떻게 피할까요?
명령 목록이 바이트의 나열이라는 점을 활용해 숫자를 바이트 배열에 직접 넣으면 됩니다. 숫자 리터럴의 명령을 다음과 같이 정의합니다.
case INST_LITERAL: {
// 바이트코드에서 다음 바이트 값을 읽습니다.
int value = bytecode[++i];
push(value);
break;
}
C++
복사
바이트코드 스트림에서 바로 다음 바이트를 숫자로 읽고 스택에 넣습니다.

그림 11-3. 바이트코드 안의 리터럴 명령과 값
원주 11-16 · 옮긴이: 무한 회귀는 종료 조건 없는 재귀 함수와 비슷합니다. 비유는 『짧고 쉽게 쓴 시간의 역사』(까치, 2006) 1장을 참고하세요.
원주 11-17: 두 바이트 이상의 정수를 디코딩하는 번거로운 코드를 피하려고 여기서는 한 바이트만 읽습니다. 실제로는 필요한 전체 숫자 범위를 표현할 리터럴을 지원해야 합니다.
명령 몇 개를 실행하며 스택을 살펴보겠습니다. 처음에는 스택이 비어 있고, 인터프리터가 첫 명령을 실행하려 합니다.

그림 11-4. 아무 명령도 실행하지 않은 상태
첫 INST_LITERAL은 옆 바이트인 0을 읽어 스택에 넣습니다.

그림 11-5. 첫 번째 리터럴 명령 실행 후
두 번째 INST_LITERAL은 10을 읽어 스택에 넣습니다.

그림 11-6. 마지막 명령을 실행하기 전
마지막으로 INST_SET_HEALTH를 실행합니다. 먼저 10을 꺼내 amount에 넣고, 다음으로 0을 꺼내 wizard에 넣어 setHealth()를 호출합니다.
우리 마법사의 체력을 10으로 만드는 마법이 완성되었습니다. 이제 양쪽 마법사의 스탯을 마음대로 바꿀 수 있고, 다른 소리와 파티클도 재생할 수 있습니다.
스택을 거꾸로 읽는 이유: 스택은 마지막에 넣은 값이 먼저 나옵니다. setHealth(wizard, amount)를 호출하려면 wizard를 먼저 넣고 amount를 나중에 넣습니다. 그래서 꺼낼 때는 amount, wizard 순서입니다. 명령마다 ‘몇 값을 꺼내고 몇 값을 넣는지’를 적어두면 데이터가 유효한지도 검사하기 쉽습니다.
하지만 아직 코드보다는 데이터에 가까워 보입니다. 예를 들어 지혜의 절반만큼 체력을 회복할 수는 없습니다. 기획자는 숫자뿐 아니라 규칙으로 마법을 표현하고 싶어 합니다.
행동 = 조합
지금 VM을 언어라고 보면 몇 개의 내장 함수와 상수 매개변수만 지원합니다. 더 많은 행동을 표현하려면 조합이 가능해야 합니다.
기획자는 여러 값을 재미있게 조합하는 표현식을 원합니다. 정해진 값이 아닌, 계산한 값으로 스탯을 바꾸는 식입니다. 현재 스탯을 고려해야 하므로 값을 설정하는 명령뿐 아니라 읽는 명령도 추가하겠습니다.
case INST_GET_HEALTH: {
int wizard = pop();
push(getHealth(wizard));
break;
}
case INST_GET_WISDOM:
case INST_GET_AGILITY:
// 무엇을 하려는지 알 것입니다...
C++
복사
이 명령은 스택에서 매개변수를 꺼내 어느 마법사인지 알아내고, 그 마법사의 스탯을 읽어 다시 스택에 넣습니다.
이제 스탯을 복사하는 마법을 만들 수 있습니다. 민첩성을 지혜와 같게 하거나, 상대방의 체력을 내 체력과 같게 할 수 있습니다.
전보다 낫지만 아직 부족합니다. 다음은 계산 능력입니다. 아기 VM에게 1+1을 가르칠 때입니다. 명령을 추가하는 방식에 이제 익숙할 테니 덧셈만 보겠습니다.
case INST_ADD: {
int b = pop();
int a = pop();
push(a + b);
break;
}
C++
복사
값 두 개를 꺼내 계산하고 결과를 다시 넣습니다. 명령을 추가할 때마다 표현력이 조금씩 늘었지만 이번에는 크게 늘었습니다. 아직 실감이 나지 않더라도 이제 여러 단계로 중첩된 복잡한 수식을 처리할 수 있습니다.
더 복잡한 예로, 우리 마법사의 체력에 민첩성과 지혜의 평균을 더하는 마법을 만들어 보겠습니다. C++로 표현하면 다음과 같습니다.
setHealth(0, getHealth(0) + (getAgility(0) + getWisdom(0)) / 2);
C++
복사
괄호를 묶는 별도 명령이 필요할 듯하지만 스택으로 암시적으로 처리할 수 있습니다. 사람이 계산하는 과정은 다음과 같습니다.
1.
현재 체력을 가져와 기억합니다.
2.
민첩성을 가져와 기억합니다.
3.
지혜를 가져와 기억합니다.
4.
민첩성과 지혜를 더하고 그 결과를 기억합니다.
5.
그 결과를 2로 나누고 결과를 기억합니다.
6.
앞서 기억한 체력을 떠올려 결과에 더합니다.
7.
이 결과를 마법사의 체력으로 설정합니다.
‘기억한다’는 ‘스택에 넣는다’로, ‘떠올린다’는 ‘스택에서 꺼낸다’로 바꾸면 바이트코드로 쉽게 옮길 수 있습니다. 첫 단계인 체력 읽기는 다음과 같습니다.
LITERAL 0
GET_HEALTH
Plain Text
복사
이 코드가 우리 마법사의 체력을 스택에 넣습니다. 나머지도 같은 방식으로 변환하면 원하는 표현식이 됩니다. 전체 변환 과정을 살펴보겠습니다.
체력은 45, 민첩성은 7, 지혜는 11이라고 가정합니다. 대괄호는 명령을 실행한 뒤의 스택이며, 오른쪽 끝이 맨 위입니다. # 뒤에는 각 명령의 목적을 적었습니다.
LITERAL 0 [0] # 마법사 인덱스
LITERAL 0 [0, 0] # 마법사 인덱스
GET_HEALTH [0, 45] # getHealth()
LITERAL 0 [0, 45, 0] # 마법사 인덱스
GET_AGILITY [0, 45, 7] # getAgility()
LITERAL 0 [0, 45, 7, 0] # 마법사 인덱스
GET_WISDOM [0, 45, 7, 11] # getWisdom()
ADD [0, 45, 18] # 민첩성과 지혜를 더함
LITERAL 2 [0, 45, 18, 2] # 제수(나누는 수)
DIVIDE [0, 45, 9] # 민첩성과 지혜의 평균을 냄
ADD [0, 54] # 평균을 현재 체력에 더함
SET_HEALTH [] # 결과를 체력으로 만듦
Plain Text
복사
스택을 단계별로 보면 데이터가 마법처럼 오갑니다. 처음에 넣은 마법사 인덱스 0은 맨 아래에 남아 있다가 마지막 SET_HEALTH에서 사용됩니다.
원주 11-18: 어쩌면 저자가 ‘마법처럼’이라는 말을 남들보다 헤프게 쓰는지도 모르겠습니다.
한 번 따라 계산하기: DIVIDE 직전 스택 맨 위에는 2, 그 아래에는 18이 있습니다. 나중에 넣은 제수 2를 먼저 꺼내고 피제수 18을 꺼내 18 / 2를 계산해야 합니다. 덧셈에서는 순서를 바꿔도 같지만 뺄셈과 나눗셈에서는 다릅니다. 이 예제는 정수 스택이므로 평균에 소수 부분이 있으면 정수 나눗셈 규칙을 따릅니다.
가상 머신
명령어를 더 추가할 수 있지만 여기서 멈추겠습니다. 이 작은 VM만으로도 간단하고 깔끔한 데이터로 행동을 자유롭게 정의할 수 있습니다. ‘바이트코드’와 ‘가상 머신’은 거창하게 들려도 기본은 스택, 반복문, 다중 선택문입니다.
이 구조는 행동을 안전하게 격리한다는 목표에도 연결됩니다. 바이트코드는 우리가 정의한 명령을 통해서만 다른 코드에 접근할 수 있습니다. 원문은 이 제한 덕분에 임의의 악성 코드를 실행하거나 잘못된 위치에 접근할 방법이 없다고 설명합니다.
스택 크기로 메모리 사용량을 제어할 수 있고, 스택 오버플로도 검사합니다. 시간 사용량도 제한할 수 있습니다. interpret()의 반복문에서 명령을 일정 개수 이상 실행하면 빠져나오게 할 수 있습니다.
이제 바이트코드를 실제로 만드는 문제만 남았습니다. 지금까지 사람이 의사코드를 손으로 컴파일했지만, 시간이 남아도는 것이 아니라면 현실적인 작업 방식은 아닙니다.
원주 11-19 · 옮긴이: push()의 assert(stackSize_ < MAX_STACK);가 스택 오버플로를 검사합니다.
원주 11-20: 이 VM에는 반복문 명령이 없으므로 별도의 실행 시간 제어 대신 바이트코드 크기만 제한해도 됩니다. 이 바이트코드는 튜링 완전하지 않다는 뜻이기도 합니다.
실제 VM의 검증은 별도 구현입니다: 바이트코드라는 형식만으로 안전해지지는 않습니다. 예제에는 읽기 범위, 잘린 리터럴, 모르는 opcode, 게임 객체 ID, 산술 오류의 검사가 생략되어 있습니다. assert도 릴리스 빌드에서 빠질 수 있으므로 신뢰할 수 없는 입력은 실행 전 또는 실행 중 명시적으로 검증하고 오류를 반환해야 합니다. ADD 전에 값이 하나뿐이면 스택 규칙 위반으로 중단해야 합니다. 이후 점프를 추가한다면 점프 대상과 실행 명령 수 제한도 필요합니다.
마법 제작 도구
처음 목표는 행동을 고수준으로 만드는 방법이었습니다. 하지만 지금 만든 것은 C++보다도 저수준입니다. 실행 성능과 격리 구조는 갖췄어도 기획자가 다룰 만하지는 않습니다.
이 간격을 메우려면 사용성이 좋은 도구가 필요합니다. 도구에서 마법 행동을 고수준으로 정의하고 저수준 스택 머신 바이트코드로 변환해야 합니다.
VM보다 더 어려워 보일 수 있습니다. 대학 컴파일러 수업에서 배운 것보다 트라우마만 남아, 책 표지의 용이나 lex, yacc만 보아도 떨리는 프로그래머도 많습니다.
텍스트 언어의 컴파일은 책에서 다루기에는 범위가 넓을 뿐 엄청나게 어려운 일은 아닙니다. 그리고 도구가 반드시 텍스트 파일을 받는 컴파일러일 필요도 없습니다.
특히 사용자가 프로그래밍에 익숙하지 않다면 그래픽 인터페이스로 행동을 정의하는 도구를 생각해 보세요. 문법 오류를 일으키기 쉬운 텍스트 작업은 컴파일러의 오류 메시지에 오래 단련된 프로그래머가 아니면 쉽지 않습니다. 작은 상자를 클릭하고 끌어 놓거나 메뉴를 선택하여 행동을 조립하게 할 수 있습니다.
원주 11-21: ‘용책’은 유명한 『Compilers: Principles, Techniques, and Tools』(사이버출판사, 2000)를 가리킵니다.
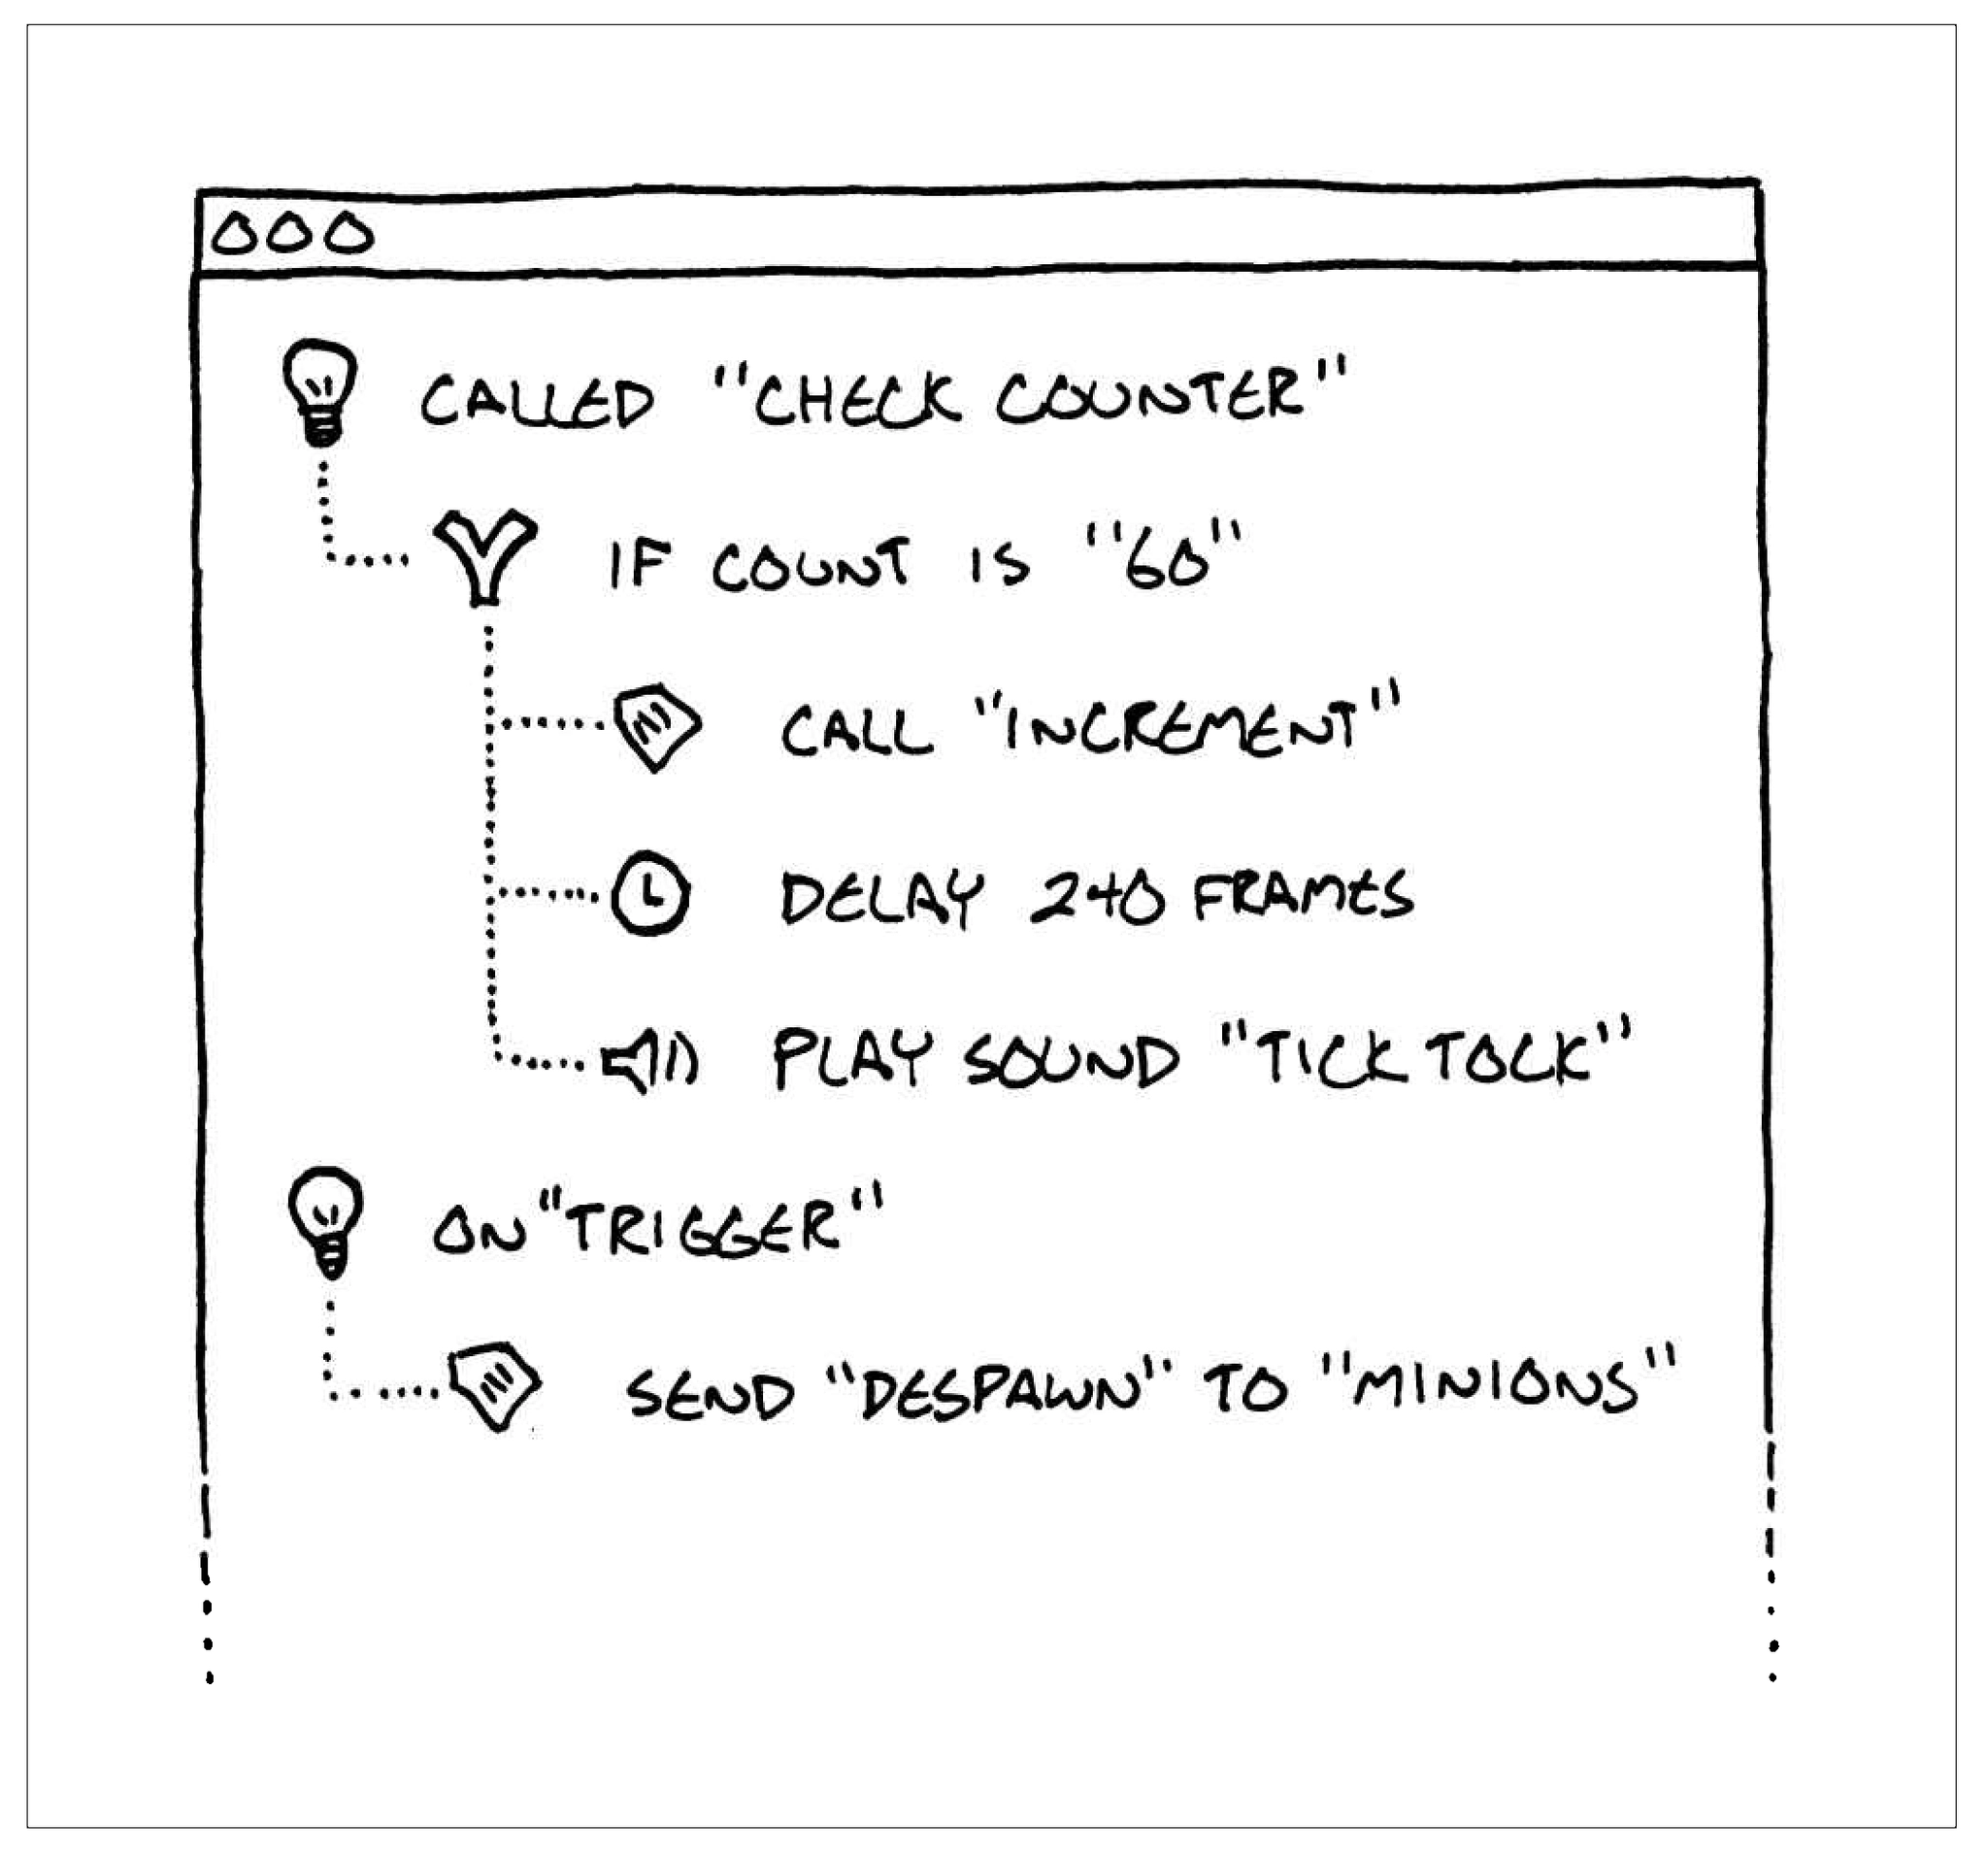
그림 11-7. 행동 제작을 위한 GUI 예
GUI에서는 사용자가 잘못된 형태의 코드를 아예 만들지 못하게 할 수 있습니다. 오류를 내보내는 대신 해당 버튼을 비활성화하거나 기본값을 넣으면 제작 과정에서 유효한 상태를 유지할 수 있습니다.
그러면 언어의 문법이나 파서를 만들지 않아도 됩니다. 물론 UI 프로그래밍을 컴파일러만큼 꺼리는 사람도 있습니다. 그렇다면 더 도와드릴 방법이 없겠습니다.
원주 11-22: 저자가 《헨리 해츠워스 인 더 퍼즐링 어드벤처(Henry Hatsworth in the Puzzling Adventure)》 개발팀에서 만든 스크립트 시스템이 이 방식이었습니다. 옮긴이는 비슷한 사례로 《아키에이지》의 웹 기반 콘텐츠 개발 도구 DDCMS를 들며 『위대한 게임의 탄생 3』(지앤선, 2013) 175쪽을 참고하라고 덧붙였습니다. 《최강의 군단》 팀은 언리얼의 그래프 편집 인터페이스로 스킬 도구를 만들었으며, NDC 16의 ‘캐릭터 한 달에 하나씩 업데이트 하기’ 발표에서도 다룹니다.
원주 11-23: 오류 처리는 매우 중요합니다. 프로그래머는 인간의 실수를 노력으로 없애야 하는 인격적 결함처럼 보는 경향이 있습니다. 하지만 사용자가 시스템을 좋아하게 하려면 인간적인 면과 실수도 받아들여야 합니다. 누구나 실수하며 창조 과정에서는 특히 피할 수 없습니다. 실행 취소처럼 실수를 부드럽게 처리하는 기능은 더 창조적이고 훌륭한 결과를 만드는 데 도움이 됩니다.
이 패턴의 궁극적인 목적은 사용자가 행동을 편한 고수준 형식으로 표현하게 하는 것입니다. 먼저 사용성을 좋게 만드는 데 힘써야 합니다. 그다음 실행을 최적화하려고 저수준으로 변환합니다. 쉬운 일은 아니지만 제대로 만들면 노력에 걸맞은 결실을 얻습니다.
11.7 디자인 결정
최대한 단순하게 설명하려 했지만 언어를 만드는 주제라 쉽지 않았습니다. 새로운 언어에는 제약이 거의 없습니다. 언어를 가지고 노는 재미에 빠져 게임 출시라는 최종 목표를 잊지 않도록 조심해야 합니다.
원주 11-24: 이 장이 책에서 가장 긴 것을 보면 단순하게 쓰려는 시도는 실패한 것 같습니다.
명령어는 스택에 어떻게 접근하는가?
바이트코드 VM은 보통 스택 기반과 레지스터 기반으로 나뉩니다. 스택 기반은 예제처럼 항상 스택 맨 위에 접근합니다. INST_ADD는 맨 위에서 두 값을 꺼내 더하고 결과를 다시 넣습니다.
레지스터 기반 VM에도 스택은 있습니다. 다만 명령어가 스택 안쪽의 입력값에도 접근할 수 있습니다. 덧셈 명령이 항상 맨 위에서 피연산자를 꺼내는 대신, 바이트코드에 두 인덱스를 넣어 원하는 위치의 값을 읽습니다.
스택 기반 VM:
•
명령어가 짧습니다. 인수를 암시적으로 맨 위에서 가져오므로 위치 데이터를 따로 인코딩하지 않아도 됩니다. 대부분 한 바이트로 충분합니다.
•
코드 생성이 간단합니다. 컴파일러나 생성 도구를 만들어 보면 이 방식이 더 쉽다는 것을 알 수 있습니다. 모든 명령이 맨 위 값으로 작업하므로 순서만 잘 배치하면 명령끼리 매개변수를 주고받습니다.
•
명령어 수가 많습니다. 맨 위만 볼 수 있으므로 a = b + c를 실행하려면 b와 c를 넣고, 더하고, 결과를 a로 옮기는 여러 명령이 필요합니다.
레지스터 기반 VM:
•
명령어가 깁니다. 스택 오프셋을 인수로 포함하므로 한 명령에 더 많은 비트가 필요합니다. 널리 알려진 레지스터 기반 언어인 루아의 예에서는 한 명령이 32비트이며, 그중 6비트는 명령 종류이고 나머지는 인수입니다.
•
명령어 수가 줄어듭니다. 한 명령이 더 많은 일을 하므로 전체 명령이 적어집니다. 스택에 값을 주고받는 횟수가 줄어 성능 향상도 기대할 수 있습니다.
가능하면 스택 기반 VM을 권합니다. 구현이 쉽고 코드 생성도 훨씬 단순합니다. 루아 이후로 레지스터 기반이 빠르다고 알려졌지만, 실제 차이는 명령어와 VM을 어떻게 설계하고 구현하느냐에 더 크게 좌우됩니다.
원주 11-25: 루아 팀은 바이트코드 형식을 따로 고정하여 명시하지 않고 버전이 바뀔 때 변경하기도 합니다. 여기의 설명은 루아 5.1 기준입니다. 자세히 보려면 A No-Frills Introduction to Lua 5.1 VM Instructions를 읽어 보세요.
어떤 명령어를 만들어야 하는가?
명령어 집합은 바이트코드가 할 수 있는 일의 범위를 정하며 성능에도 큰 영향을 줍니다. 필요한 종류를 살펴보겠습니다.
외부 원시명령:
VM 밖의 게임 코드에 접근하여 플레이어가 볼 수 있는 일을 처리합니다. 바이트코드로 표현할 행동의 범위를 결정합니다. 이런 명령이 없다면 VM은 CPU를 공회전시키는 것 외에 할 일이 없습니다.
내부 원시명령:
리터럴, 산술, 비교, 그 밖의 스택 입출력 명령으로 VM 내부의 값을 다룹니다.
흐름 제어:
예제에서는 생략했지만 조건에 따라 실행하거나 반복하려면 흐름 제어가 필요합니다. 바이트코드 같은 저수준 언어에서는 점프(jump)를 사용하면 됩니다.
인터프리터의 반복문에는 현재 실행 중인 바이트코드 위치를 기록하는 인덱스가 있습니다. 점프는 이 값을 바꾸어 실행 위치를 옮기는 것뿐입니다. goto와 같은 일이며, 다양한 고수준 흐름 제어도 점프로 만들 수 있습니다.
추상화:
사용자가 만드는 데이터가 커지면 매번 복사하고 붙이기보다 바이트코드를 재사용하고 싶어집니다. 호출할 수 있는 프로시저 같은 것이 필요해집니다.
기본 형태만 보면 프로시저는 점프보다 크게 복잡하지 않습니다. 차이는 VM이 별도의 반환 스택을 관리한다는 것입니다. 호출(call)을 만나면 현재 실행 인덱스를 반환 스택에 넣고 대상 바이트코드로 점프합니다. 반환(return)을 만나면 스택에서 복귀할 인덱스를 꺼내 그 위치로 돌아갑니다.
값을 어떻게 표현할 것인가?
예제는 정수 하나만 지원하므로 스택도 정수 배열입니다. 더 본격적인 VM은 문자열, 객체, 리스트 등 다른 자료형도 지원해야 합니다. 이들을 내부에서 어떻게 저장할지 정해야 합니다.
단일 자료형:
•
간단합니다. 태그, 변환, 자료형 검사를 신경 쓰지 않아도 됩니다.
•
다른 자료형을 다룰 수 없습니다. 명백한 단점입니다. 여러 종류를 하나의 자료형으로 나타내는 일은 번거롭습니다. 모든 숫자를 문자열로 저장해야 한다고 생각해 보세요.
태그 붙은 변수:
동적 자료형 언어에 흔한 방식입니다. 각 값은 두 부분입니다. 먼저 열거형으로 어떤 자료형인지 나타내는 태그를 두고, 나머지 비트는 그 자료형에 맞게 해석합니다.
enum ValueType {
TYPE_INT,
TYPE_DOUBLE,
TYPE_STRING
};
struct Value {
ValueType type;
union {
int intValue;
double doubleValue;
char* stringValue;
};
};
C++
복사
•
값이 자신의 자료형을 압니다. 런타임에 확인할 수 있어 동적 디스패치에 유용하며, 지원하지 않는 자료형의 연산을 막을 수 있습니다.
•
메모리가 더 필요합니다. 모든 값에 구분 비트를 추가해야 합니다. VM 같은 저수준 코드에서는 값마다 비트가 조금만 늘어도 전체 메모리는 크게 늘어납니다.
원주 11-26 · 옮긴이: 예전 COM 개발자라면 VARIANT가 이런 형태였다는 것을 기억할 것입니다.
태그 없는 공용체:
공용체(union)를 사용하되 자료형 태그는 두지 않습니다. 비트만 보고는 종류를 알 수 없으므로 올바르게 해석할 책임이 우리에게 있습니다.
정적 자료형 언어는 이런 방식으로 데이터를 메모리에 표현합니다. 컴파일할 때 타입 시스템이 올바른 해석을 보장하므로 런타임에서 다시 검사하지 않아도 됩니다.
•
작습니다. 값만 저장하므로 더 줄이기 어렵습니다.
•
빠릅니다. 태그를 런타임에 검사하는 시간을 쓰지 않습니다. 정적 자료형 언어가 동적 자료형 언어보다 빠를 수 있는 이유 중 하나입니다.
•
안전하지 않습니다. 큰 단점입니다. 잘못된 바이트코드가 숫자를 포인터로, 또는 포인터를 숫자로 해석하면 공격에 노출되거나 크래시를 일으킬 수 있습니다.
원주 11-27: 어셈블리나 Forth처럼 자료형이 없는 언어도 이렇게 저장합니다. 이런 언어에서는 개발자가 값을 올바른 자료형으로 해석하도록 직접 코딩해야 합니다. 마음이 약한 사람이 다루기에는 어렵습니다.
원주 11-28: 정적 자료형 언어의 컴파일러가 안전한 바이트코드를 만들었다고 안심할 수도 있습니다. 틀린 말은 아니지만 악의적인 사용자는 컴파일러를 거치지 않고 직접 잘못된 바이트코드를 넣을 수 있습니다. 자바 VM이 로드할 때 바이트코드를 검증하는 데에는 이유가 있습니다.
인터페이스:
객체지향에서는 여러 종류 중 무엇인지 모르는 값을 다형성으로 다룹니다. 자료형을 검사하고 변환할 가상 메서드를 가진 인터페이스를 만들 수 있습니다.
class Value {
public:
virtual ~Value() {}
virtual ValueType type() = 0;
virtual int asInt() {
// 이 가상 함수는 정수형에서만 호출해야 합니다.
assert(false);
return 0;
}
// 다른 변환 메서드들...
};
C++
복사
그런 다음 각 자료형의 구체 클래스를 정의합니다.
class IntValue : public Value {
public:
IntValue(int value) : value_(value) {}
virtual ValueType type() { return TYPE_INT; }
virtual int asInt() { return value_; }
private:
int value_;
};
C++
복사
•
제한이 없습니다. 기본 인터페이스만 구현하면 VM 핵심을 바꾸지 않고도 새 자료형을 정의할 수 있습니다.
•
객체지향적입니다. 객체지향 원리주의자에게는 타입 태그를 switch로 분기하는 것보다 다형성 디스패치가 ‘올바른’ 방법입니다.
•
번거롭습니다. 자료형마다 클래스와 장황한 준비 코드를 작성해야 합니다. 방금 만든 것은 전체 자료형 중 겨우 하나입니다.
•
비효율적입니다. 다형성은 포인터로 동작하므로 불리언과 숫자 같은 단순한 값도 힙 객체로 감싸야 합니다. 값에 접근할 때마다 가상 함수도 호출합니다. VM 핵심에서는 이 작은 비용이 큰 성능 저하로 이어집니다. 코드 대신 값의 표현으로 대상만 바뀌었을 뿐, 앞서 인터프리터 패턴을 피했던 이유가 거의 그대로 남습니다.
가능하면 자료형 하나만 사용하는 것을 권합니다. 그렇지 않다면 태그 붙은 변수를 사용하세요. 다른 언어의 인터프리터도 대부분 그렇게 합니다.
바이트코드는 어떻게 만들 것인가?
마지막은 가장 중요한 질문입니다. 지금까지 읽고 해석하는 코드는 보았지만 생성 방법은 보여드리지 않았습니다. 보통 컴파일러를 만들지만 다른 선택도 있습니다.
텍스트 기반 언어를 정의한다면:
•
문법을 정의해야 합니다. 전문가도 이를 과소평가하기 쉽습니다. 파서를 만족시키기는 쉬워도 사용자를 만족시키기는 어렵습니다. 문법 설계는 문자열만으로 사용자 인터페이스를 설계하는 일이라 쉽지 않습니다.
•
파서를 구현해야 합니다. 알려진 것만큼 어렵지는 않습니다. ANTLR, Bison 같은 파서 생성기를 쓰거나, 저자처럼 간단한 재귀 하향 파서(recursive descent parser)를 직접 만들 수 있습니다.
•
문법 오류를 처리해야 합니다. 가장 중요하면서 어려운 부분입니다. 사람은 실수하므로 문법·의미 오류가 있을 때 올바른 방향으로 안내해야 합니다. 파서가 예상하지 못한 구두점에서 막혔다는 사실만 알아서는 유용한 피드백을 주기 어렵습니다.
•
프로그래머가 아닌 사람에게는 어려울 수 있습니다. 프로그래머는 텍스트를 좋아합니다. 강력한 콘솔 도구와 결합하면 레고처럼 다양하게 조합할 수 있기 때문입니다. 하지만 다른 사람은 세금 신고 내용을 전부 입력한 뒤 숫자에 쉼표 하나가 빠졌다는 팝업 때문에 처음부터 다시 해야 하는 홈택스 작업처럼 느낄 수 있습니다.
UI가 있는 저작 도구를 만든다면:
•
UI를 구현해야 합니다. 버튼, 클릭, 드래그 등을 만드는 일입니다. 싫어하는 사람도 있지만 저자는 좋아합니다. 이 방식을 선택했다면 UI 설계를 억지로 해야 하는 부수 작업이 아니라 핵심 작업으로 받아들여야 합니다. 정성을 들일수록 쉽고 편한 도구가 되며 콘텐츠도 개선됩니다. 좋아하는 게임의 개발 후일담을 찾아보면 재미의 비결로 저작 도구를 꼽는 경우가 많습니다.
•
오류가 적습니다. 행동을 상호작용하며 한 단계씩 만들므로 잘못되면 도구가 즉시 바로잡을 수 있습니다. 반면 텍스트 언어에서는 사용자가 파일을 넘기기 전까지 내용을 모르므로 오류를 예방하고 처리하기가 더 어렵습니다.
•
이식성이 낮습니다. 텍스트는 보편적입니다. 간단한 컴파일러는 파일을 읽고 결과를 출력하면 되므로 다른 OS로 옮기기 쉽습니다. UI 프로그램은 프레임워크를 골라야 하고, 많은 프레임워크가 특정 OS에 종속됩니다. 크로스 플랫폼 툴킷도 있지만 모든 OS에서 똑같이 동작하려고 친숙함을 포기하면 어느 플랫폼에서도 어색해질 수 있습니다.
원주 11-30: 텍스트의 개행 문자와 인코딩 문제는 제외하고 한 말입니다.
도구에서 바로 보여주면 좋은 정보: 현재 선택한 명령의 입력·출력 수, 실행 후 예상 스택, 잘못된 값이 발생한 행동 노드를 보여주면 기획자가 VM 구현을 몰라도 문제를 찾을 수 있습니다. 행동 데이터가 작게 시작해 커질수록 실행 취소와 오류 위치 표시가 제작 속도에 직접 영향을 줍니다.
11.8 관련 자료
•
바이트코드와 GoF의 인터프리터 패턴은 형제 관계입니다. 둘 다 데이터로 행동을 조합합니다. 실제로 함께 쓰는 경우가 많습니다. 바이트코드 생성 도구가 내부에서 코드의 객체 트리를 만들면 인터프리터 패턴과 같은 표현을 사용하게 됩니다. 이를 컴파일할 때도 재귀적으로 트리를 순회합니다. 차이는 행동을 즉시 실행하는 대신 나중에 실행할 바이트코드 명령으로 출력한다는 것입니다.
•
루아는 게임 분야에서 널리 사용되는 스크립트 언어이며, 레지스터 기반 바이트코드 VM으로 간결하게 구현되어 있습니다.
•
키즈멧(Kismet)은 언리얼 에디터에 포함된 그래픽 스크립트 도구입니다.
•
저자가 만든 렌(Wren)은 단순한 스택 기반 바이트코드 인터프리터입니다.