


삼각형 없이 텍스처의 모든 픽셀을 계산해 봅시다
이미지를 그리는 방법이 꼭 정점과 삼각형을 거칠 필요는 없습니다. 출력 텍스처의 (x,y)에 어떤 색을 쓸지 계산할 수 있다면 Compute Shader의 스레드 하나에 픽셀 하나를 맡길 수 있습니다. 이번에는 16×16 스레드 그룹으로 반복 무늬를 만들고 그 결과를 백버퍼로 복사해 보겠습니다.
이 글은 Compute의 선택 학습 예제입니다. 현재 YamYam Scene/Game에 이 효과가 구현되어 있다는 뜻은 아닙니다. 앞 초기화의 Device, Direct Queue/List, Fence, 백버퍼가 준비되었다고 가정하고 CS·UAV·Dispatch 연결을 설명합니다.
flowchart LR
    D[Dispatch: 그룹 수] --> C[CS: numthreads]
    C --> U[UAV 텍스처 쓰기]
    U --> B[UAV → COPY_SOURCE]
    B --> P[같은 크기·포맷의 백버퍼에 복사]
    P --> S[COPY_DEST → PRESENT]
Mermaid
복사
이번 예제의 데이터가 흐르는 방향
16의 배수가 아닌 해상도도 처리하려고 그룹 수를 올림하므로 CS 내부의 경계 검사가 필요합니다. UAV 쓰기 뒤 COPY_SOURCE 전환은 다음 복사와 순서를 연결합니다. UAV 상태를 유지한 채 의존하는 다음 Dispatch를 수행하는 경우에는 필요한 UAV Barrier를 검토합니다. 별도 Compute Queue를 쓰면 Queue 간 Fence 동기화를 추가해야 합니다. Microsoft: Resource Barrier
Compute Pipeline은 정점·래스터라이저 단계 없이 Compute Shader를 실행합니다. 단계는 적지만 병렬 알고리즘과 메모리 동기화까지 항상 쉬운 것은 아닙니다.
리소스를 Root Signature로 연결하고, Dispatch로 스레드 그룹을 실행합니다.
컴퓨트 파이프라인을 살펴 봅시다.
Resources
연산에 필요한 SRV·UAV·상수 버퍼를 준비합니다. 삼각형 데이터가 필수는 아니며, UAV는 Compute 전용 리소스도 아닙니다. 이 예제는 UAV 텍스처 한 장을 출력으로 사용합니다.
// Root Signature 1.0 학습 예시: u0 UAV table 하나.
D3D12_DESCRIPTOR_RANGE range = {};
range.RangeType = D3D12_DESCRIPTOR_RANGE_TYPE_UAV;
range.NumDescriptors = 1;
range.BaseShaderRegister = 0;
D3D12_ROOT_PARAMETER param = {};
param.ParameterType = D3D12_ROOT_PARAMETER_TYPE_DESCRIPTOR_TABLE;
param.ShaderVisibility = D3D12_SHADER_VISIBILITY_ALL;
param.DescriptorTable = {1, &range};
D3D12_ROOT_SIGNATURE_DESC desc = {};
desc.NumParameters = 1;
desc.pParameters = ¶m;
ComPtr<ID3DBlob> signature, error;
HRESULT hr = D3D12SerializeRootSignature(&desc, D3D_ROOT_SIGNATURE_VERSION_1,
signature.GetAddressOf(), error.GetAddressOf());
if (error) OutputDebugStringA(static_cast<const char*>(error->GetBufferPointer()));
ThrowIfFailed(hr);
ComPtr<ID3D12RootSignature> rootSignature;
ThrowIfFailed(device->CreateRootSignature(0, signature->GetBufferPointer(),
signature->GetBufferSize(), IID_PPV_ARGS(&rootSignature)));
C++
복사
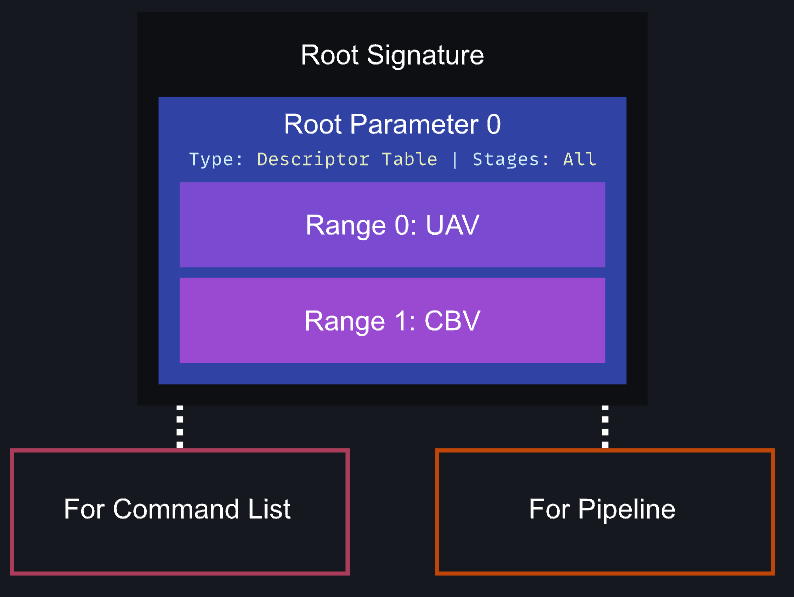
u0는 HLSL의 RWTexture2D 레지스터입니다. root parameter 0은 이 UAV 하나를 담은 descriptor table로 선언합니다. 나중에 SetComputeRootDescriptorTable(0, uavGPU)을 호출하면 그 시작 handle이 u0에 연결됩니다. Compute에는 Vertex/Pixel 가시성 구분을 쓰지 않아 ShaderVisibility=ALL로 둡니다.
Compute Shaders
Compute Pipeline의 셰이더 단계는 CS 하나입니다. 이 예제의 한 그룹은 16×16×1 스레드이며 각 스레드가 출력 픽셀 하나를 담당합니다.
그룹 안의 좌표와 전체 좌표를 나눕니다
그룹 크기가 16×16이면 그룹 안 x,y는 각각 0~15입니다. 그룹 (1,0)의 로컬 좌표 (3,5)는 전체 출력에서 (19,5)를 담당합니다. 전체 좌표는 그룹 번호 × 그룹 크기 + 그룹 안 좌표로 연결됩니다.
// HLSL: main을 cs_5_0 등 이 예제에 맞는 프로파일로 컴파일합니다.
RWTexture2D<float4> outputTexture : register(u0);
[numthreads(16, 16, 1)]
void main(uint3 localID : SV_GroupThreadID, uint3 globalID : SV_DispatchThreadID)
{
uint width, height;
outputTexture.GetDimensions(width, height);
if (globalID.x >= width || globalID.y >= height) return;
outputTexture[globalID.xy] = float4(
float(localID.x) / 16.0, float(localID.y) / 16.0,
float(globalID.x) / float(width), 1.0);
}
// SV_GroupID는 그룹 번호, SV_GroupThreadID는 그룹 안의 좌표입니다.
// SV_GroupIndex는 그룹 안의 스레드를 일렬로 센 번호입니다.
C++
복사
출력의 R과 G는 localID를 사용하므로 16픽셀마다 다시 0으로 돌아갑니다. B는 globalID.x를 width로 나누므로 전체 화면 왼쪽에서 오른쪽으로 증가합니다. 그 결과 작은 타일 무늬 위에 가로 방향의 파랑 변화가 함께 보입니다. 모든 채널을 globalID 기준으로 바꾸면 반복되는 타일 경계가 사라지는 실험을 할 수 있습니다.
해상도가 17×17이면 한 그룹으로 부족해 2×2그룹을 실행합니다. 실제 실행 영역은 32×32이므로 1024개 스레드 중 289개만 유효한 픽셀입니다. 앞의 경계 검사로 나머지는 쓰기 전에 반환합니다. “그룹 수를 올림”과 “셰이더에서 경계 검사”가 한 쌍인 이유입니다.
Pipeline State
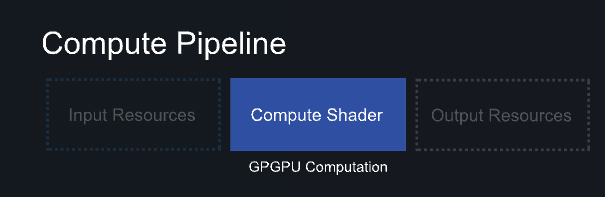
Compute PSO의 핵심은 CS 바이트코드와 Root Signature입니다. 실제 실행에는 descriptor·리소스 상태·명령 목록·동기화도 필요합니다.
// compShader는 성공적으로 컴파일한 CS 바이트코드입니다.
D3D12_COMPUTE_PIPELINE_STATE_DESC psoDesc = {};
psoDesc.pRootSignature = rootSignature.Get();
psoDesc.CS = {compShader->GetBufferPointer(), compShader->GetBufferSize()};
ComPtr<ID3D12PipelineState> pipelineState;
ThrowIfFailed(device->CreateComputePipelineState(&psoDesc, IID_PPV_ARGS(&pipelineState)));
// 실패를 출력만 하고 Dispatch로 진행하지 않습니다.
C++
복사
CS만 사용하므로 InputLayout·VS·PS·Blend·RTV 포맷을 Compute PSO에 넣지 않습니다. compShader는 앞 HLSL의 main을 컴파일해 얻은 바이트코드입니다. 단, PSO 단계가 적다는 것이 전체 알고리즘이나 동기화가 자동으로 쉬워진다는 뜻은 아닙니다. 서로 다른 스레드가 같은 주소를 수정한다면 별도의 경쟁·동기화 문제를 풀어야 합니다.
Unordered Access View
셰이더가 쓰는 RWTexture2D를 실제 GPU 텍스처와 연결할 차례입니다. Resource에는 픽셀 저장 공간이 있고 UAV descriptor에는 쓰기 대상으로 접근할 형식과 범위가 들어 있습니다. Root Signature에 u0를 선언한 것만으로 이 저장 공간이 생기지는 않습니다.
// d3dx12.h 사용. width/height > 0, 백버퍼와 같은 크기·포맷·샘플 수를 전제합니다.
D3D12_DESCRIPTOR_HEAP_DESC heapDesc = {};
heapDesc.NumDescriptors = 1;
heapDesc.Type = D3D12_DESCRIPTOR_HEAP_TYPE_CBV_SRV_UAV;
heapDesc.Flags = D3D12_DESCRIPTOR_HEAP_FLAG_SHADER_VISIBLE;
ComPtr<ID3D12DescriptorHeap> uavHeap;
ThrowIfFailed(device->CreateDescriptorHeap(&heapDesc, IID_PPV_ARGS(&uavHeap)));
const auto props = CD3DX12_HEAP_PROPERTIES(D3D12_HEAP_TYPE_DEFAULT);
const auto texDesc = CD3DX12_RESOURCE_DESC::Tex2D(
DXGI_FORMAT_R8G8B8A8_UNORM, width, height, 1, 1, 1, 0,
D3D12_RESOURCE_FLAG_ALLOW_UNORDERED_ACCESS);
ComPtr<ID3D12Resource> outputTexture;
ThrowIfFailed(device->CreateCommittedResource(&props, D3D12_HEAP_FLAG_NONE,
&texDesc, D3D12_RESOURCE_STATE_UNORDERED_ACCESS, nullptr,
IID_PPV_ARGS(&outputTexture)));
D3D12_UNORDERED_ACCESS_VIEW_DESC uavDesc = {};
uavDesc.Format = texDesc.Format;
uavDesc.ViewDimension = D3D12_UAV_DIMENSION_TEXTURE2D;
const auto uavCPU = uavHeap->GetCPUDescriptorHandleForHeapStart();
const auto uavGPU = uavHeap->GetGPUDescriptorHandleForHeapStart();
device->CreateUnorderedAccessView(outputTexture.Get(), nullptr, &uavDesc, uavCPU);
// 이 예제는 descriptor 1개를 사용합니다. CPU/GPU handle은 같은 슬롯을 가리킵니다.
C++
복사
ALLOW_UNORDERED_ACCESS는 이 텍스처를 UAV 쓰기 대상으로 사용할 수 있게 합니다. 초기 상태도 UNORDERED_ACCESS이므로 첫 Dispatch가 여기에 기록합니다. CreateUnorderedAccessView에는 CPU handle을, 명령 목록의 table 바인딩에는 같은 슬롯의 GPU handle을 사용합니다.
이 예제는 백버퍼에 CopyResource로 옮기므로 크기·포맷·샘플 수를 서로 맞춥니다. 원하는 모든 백버퍼를 곧바로 UAV로 쓸 수 있다고 가정하지 않고 별도 출력 텍스처를 둡니다. 이 장에서는 R8G8B8A8_UNORM single-sample 텍스처 한 장부터 확인합니다.
Compute Calls
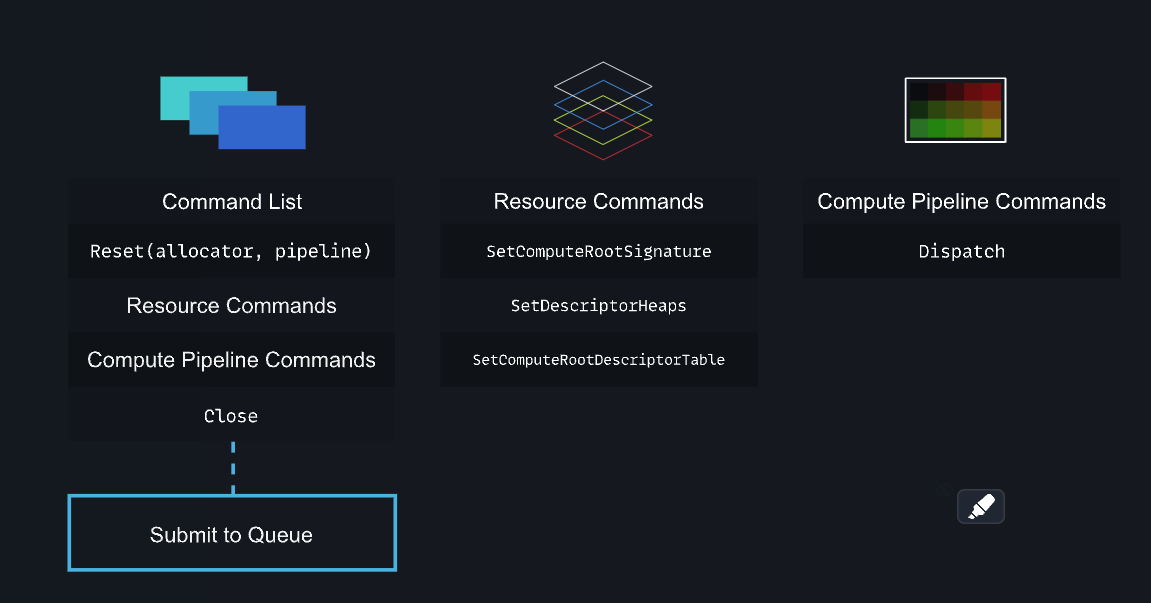
컴퓨트 호출 실행은 주어진 스레드 그룹 세트를 인수로 Dispatch를 호출하여 실행한다. 화면 공간 계산 셰이더를 실행할 것이므로 화면의 모든 16x16 블록에 대한 그룹이 인수로 있을 것이다.
Dispatch의 인자는 스레드 수가 아니라 그룹 수입니다
가로 1920, 세로 1080이라면 x는 120그룹, y는 68그룹입니다. y의 마지막 그룹에서 일부 스레드는 1080 바깥이라 CS 경계 검사로 빠집니다. DIRECT List에서 Compute와 백버퍼 복사를 함께 기록하므로 별도 Compute Queue 사이의 동기화는 이번 예제에 필요하지 않습니다.
// DIRECT Queue/List에서 Compute와 백버퍼 복사를 함께 기록하는 함수 내부입니다.
// 이전 GPU 사용 완료 뒤 allocator Reset. backBuffer는 현재 백버퍼 raw pointer.
ThrowIfFailed(commandAllocator->Reset());
ThrowIfFailed(commandList->Reset(commandAllocator, pipelineState.Get()));
commandList->SetComputeRootSignature(rootSignature.Get());
ID3D12DescriptorHeap* heaps[] = {uavHeap.Get()};
commandList->SetDescriptorHeaps(1, heaps);
commandList->SetComputeRootDescriptorTable(0, uavGPU);
const auto groups = [](UINT value) { return value / 16 + (value % 16 != 0); };
commandList->Dispatch(groups(width), groups(height), 1);
D3D12_RESOURCE_BARRIER beforeCopy[] = {
CD3DX12_RESOURCE_BARRIER::Transition(outputTexture.Get(),
D3D12_RESOURCE_STATE_UNORDERED_ACCESS, D3D12_RESOURCE_STATE_COPY_SOURCE),
CD3DX12_RESOURCE_BARRIER::Transition(backBuffer,
D3D12_RESOURCE_STATE_PRESENT, D3D12_RESOURCE_STATE_COPY_DEST)
};
commandList->ResourceBarrier(2, beforeCopy);
commandList->CopyResource(backBuffer, outputTexture.Get());
D3D12_RESOURCE_BARRIER afterCopy[] = {
CD3DX12_RESOURCE_BARRIER::Transition(outputTexture.Get(),
D3D12_RESOURCE_STATE_COPY_SOURCE, D3D12_RESOURCE_STATE_UNORDERED_ACCESS),
CD3DX12_RESOURCE_BARRIER::Transition(backBuffer,
D3D12_RESOURCE_STATE_COPY_DEST, D3D12_RESOURCE_STATE_PRESENT)
};
commandList->ResourceBarrier(2, afterCopy);
ThrowIfFailed(commandList->Close());
// 이어서 ExecuteCommandLists, Present, Fence 처리를 수행합니다.
C++
복사
Dispatch 이후 출력 텍스처는 UAV 쓰기에서 COPY_SOURCE 읽기로, 백버퍼는 PRESENT에서 COPY_DEST 쓰기로 전환합니다. CopyResource가 끝난 뒤 각각 다음 Dispatch용 UNORDERED_ACCESS와 화면 표시용 PRESENT로 되돌립니다. 상태 전환은 작업의 접근 순서를 연결하고, CPU에서 다음 프레임 메모리·Allocator를 재사용할 조건은 Fence가 보장합니다.
CopyResource는 이미지 크기를 바꾸거나 색 공간을 변환하는 그리기 함수가 아닙니다. 백버퍼를 리사이즈했다면 출력 텍스처도 맞춰 다시 만들고, 이전 리소스가 GPU에서 사용 중인지 확인해야 합니다. 다음 패스도 UAV 상태로 같은 데이터에 의존한다면 적절한 UAV Barrier가 필요한지 판단합니다.
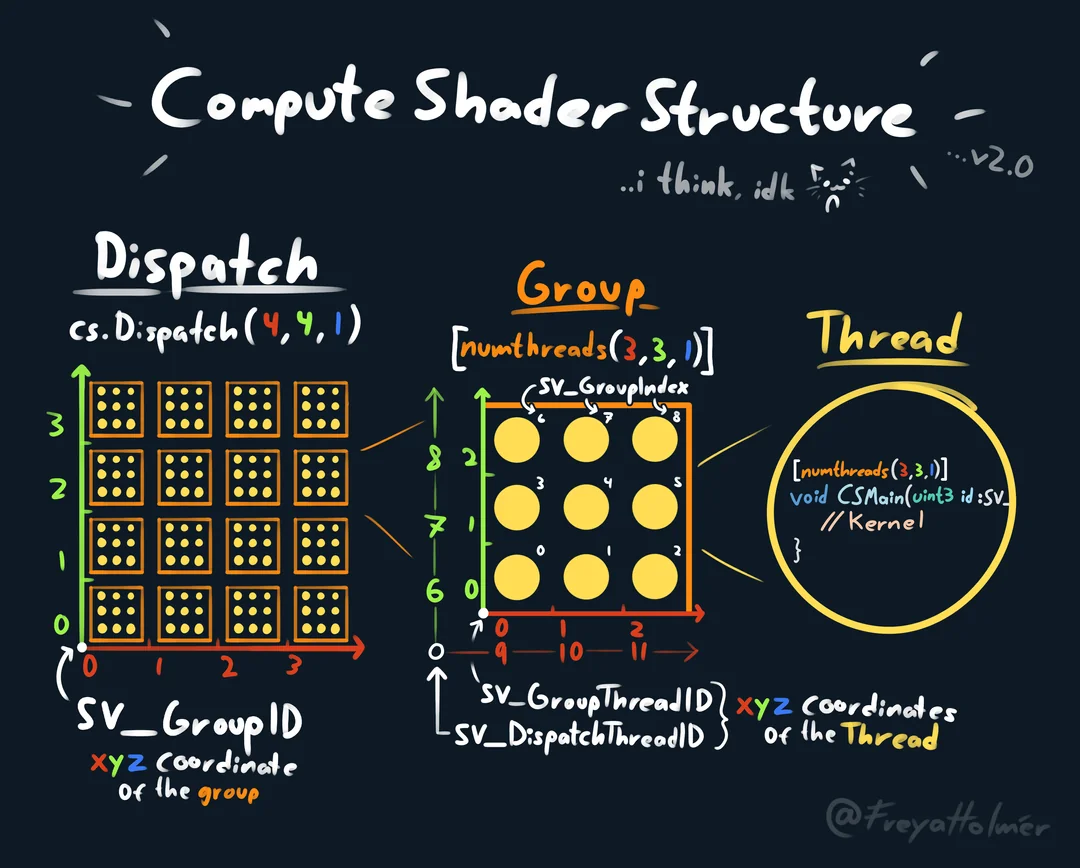
무늬를 바꾸며 실행 범위를 확인합니다
17×17처럼 그룹 크기로 나누어떨어지지 않는 작은 해상도로 먼저 생각해 보고, 실제 화면에서는 16픽셀마다 반복되는 R/G와 전체 화면에 걸친 B의 변화를 비교합니다. globalID 대신 localID를 사용한 채 전체 이미지의 그라데이션을 기대하면 반복 무늬가 나오는 이유를 이제 설명할 수 있습니다.
UAV 쓰기는 곧 화면 표시가 아닙니다. PSO와 root table이 맞고 Dispatch가 실행되어도 복사·Present가 연결되지 않으면 화면에는 결과가 나타나지 않습니다. 이후에는 같은 출력 텍스처를 SRV로 전환해 후처리나 ImGui Image에서 읽는 방식으로 확장할 수 있습니다.