



Abstract
주요 sequence transduction 모델들은 복잡한 recurrent 또는 convolutional neural networks를 기반으로 하고, 여기에는 encoder와 decoder가 포함되어 있어요. 성능이 가장 좋은 모델들은 attention mechanism을 통해 encoder와 decoder를 연결하기도 하죠. 우리는 새로운 간단한 네트워크 구조인 Transformer를 제안해요. 이 구조는 오직 attention mechanism에만 기반을 두고, recurrence와 convolution을 완전히 없앴답니다. 두 가지 기계 번역 작업에 대한 실험 결과, 이 모델들이 품질 면에서 우수할 뿐만 아니라 병렬 처리도 더 잘 되고, 훈련 시간도 훨씬 적게 필요하다는 것을 보여줬어요. 우리 모델은 WMT 2014 영어-독일어 번역 작업에서 28.4 BLEU를 달성했는데, 이는 기존의 최고 결과, 특히 앙상블 모델보다 2 BLEU 이상 개선된 것이랍니다. WMT 2014 영어-프랑스어 번역 작업에서는 8개의 GPU로 3.5일 동안 훈련한 후 41.8이라는 새로운 단일 모델의 최고 BLEU 점수를 기록했어요. 이는 문헌에서 가장 좋은 모델들의 훈련 비용의 일부분에 불과하죠. 우리는 Transformer가 다른 작업에도 잘 일반화된다는 것을 보여주었고, 이를 대규모 및 제한된 훈련 데이터로 영어 구성 구문 분석에 성공적으로 적용했답니다.
•
동일한 기여를 했어요. 나열 순서는 무작위입니다. Jakob은 RNNs을 self-attention으로 대체하는 것을 제안하고 이 아이디어를 평가하는 노력을 시작했어요. Ashish는 Illia와 함께 첫 번째 Transformer 모델을 설계하고 구현했으며, 이 작업의 모든 측면에 중요한 역할을 했답니다. Noam은 scaled dot-product attention, multi-head attention, 그리고 parameter-free position representation을 제안했고, 거의 모든 세부 사항에 관여했어요. Niki는 원래 코드베이스와 tensor2tensor에서 수많은 모델 변형을 설계, 구현, 조정, 평가했어요. Llion은 새로운 모델 변형을 실험하고, 초기 코드베이스와 효율적인 추론 및 시각화를 담당했어요. Lukasz와 Aidan은 tensor2tensor의 다양한 부분을 설계하고 구현하는 데 많은 시간을 보냈고, 이전 코드베이스를 대체하여 결과를 크게 개선하고 연구를 대폭 가속화했어요.
1 Introduction
Recurrent neural networks, 특히 long short-term memory [13]와 gated recurrent [7] neural networks는 시퀀스 모델링과 언어 모델링, 기계 번역 같은 변환 문제에서 최첨단 접근 방식으로 확고히 자리 잡았어요 [35, 2, 5]. 이후로도 수많은 노력이 반복 언어 모델과 encoder-decoder 아키텍처의 경계를 계속해서 확장하고 있답니다 [38, 24, 15].
Recurrent 모델은 보통 입력과 출력 시퀀스의 각 심볼 위치에 따라 계산을 나누어요. 이 위치들을 계산 시간의 단계에 맞춰 정렬하면서, 이전 숨겨진 상태 hₜ₋₁와 위치 t의 입력을 함수로 사용해 숨겨진 상태 hₜ의 시퀀스를 생성하죠. 이런 본질적인 순차적 특성 때문에, 훈련 예제 내에서 병렬 처리가 어렵습니다. 특히 시퀀스 길이가 길어질수록 메모리 제약으로 인해 예제 간 배치가 제한되기 때문에 중요해지죠. 최근 연구에서는 factorization tricks[21]와 conditional computation[32]을 통해 계산 효율성을 크게 개선했어요. 후자의 경우 모델 성능도 향상되었답니다. 하지만 순차적 계산의 근본적인 제약은 여전히 남아 있어요.
Attention 메커니즘은 다양한 작업에서 시퀀스 모델링과 변환 모델의 중요한 부분이 되었어요. 입력이나 출력 시퀀스에서 거리와 상관없이 의존성을 모델링할 수 있게 해주거든요[2, 19]. 하지만 몇 가지 경우[27]를 제외하고는, 이러한 attention 메커니즘은 보통 recurrent 네트워크와 함께 사용돼요.
이번 연구에서는 Transformer라는 모델 아키텍처를 제안해요. 이 모델은 recurrence를 피하고, 대신 입력과 출력 간의 전역적인 의존성을 끌어내기 위해 완전히 attention 메커니즘에 의존합니다. Transformer는 병렬 처리를 훨씬 더 많이 허용하고, 8개의 P100 GPU에서 단 12시간 동안 훈련한 후에도 번역 품질에서 새로운 최첨단 수준에 도달할 수 있어요.
2 Background
순차적인 계산을 줄이는 목표는 Extended Neural GPU [16], ByteNet [18], ConvS2S [9]의 기초가 되기도 해요. 이 모델들은 모두 convolutional neural networks를 기본 구성 요소로 사용해서, 입력과 출력 위치에 대해 병렬로 hidden representations를 계산하거든요. 이 모델들에서는 두 임의의 입력 또는 출력 위치 간의 신호를 연결하는 데 필요한 연산 수가 위치 간 거리와 함께 증가해요. Transformer에서는 이 연산 수가 일정하게 줄어들지만, attention-weighted 위치를 평균화하면서 효과적인 해상도가 감소하는 단점이 있어요. 이 문제는 3.2절에서 설명한 Multi-Head Attention으로 보완해요.
Self-attention, 때로는 intra-attention이라고도 불리는데요, 이는 하나의 sequence 내의 서로 다른 위치를 연결해서 그 sequence의 표현을 계산하는 attention mechanism이에요. Self-attention은 독해, 추상적 요약, 텍스트 함의, 그리고 작업에 독립적인 문장 표현 학습 등 다양한 작업에서 성공적으로 사용되었어요 [4, 27, 28, 22].
End-to-end memory networks는 sequence-aligned recurrence 대신에 recurrent attention mechanism을 기반으로 하고 있어요. 간단한 언어의 질문 응답과 언어 모델링 작업에서 좋은 성능을 보였답니다 [34].
하지만 우리가 아는 한, Transformer는 sequence-aligned RNNs나 convolution을 사용하지 않고, 오직 self-attention에만 의존해서 입력과 출력의 표현을 계산하는 최초의 변환 모델이에요. 다음 섹션에서는 Transformer를 설명하고, self-attention의 동기를 부여하며, [17, 18] 및 [9]과 같은 모델들에 비해 어떤 장점이 있는지 논의할 거예요.
3 모델 아키텍처
대부분의 경쟁력 있는 신경망 시퀀스 변환 모델은 encoder-decoder 구조를 가지고 있어요 [5, 2, 35]. 여기서 encoder는 기호 표현의 입력 시퀀스 (x₁,...,xₙ)를 연속적인 표현의 시퀀스 Z = (z₁,...,zₙ)로 변환해요. z가 주어지면, decoder는 기호의 출력 시퀀스 (y₁,...,ym)를 한 번에 하나씩 생성하죠. 이 모델은 auto-regressive [10] 방식으로, 이전에 생성된 기호들을 다음 기호를 생성할 때 추가 입력으로 사용해요.
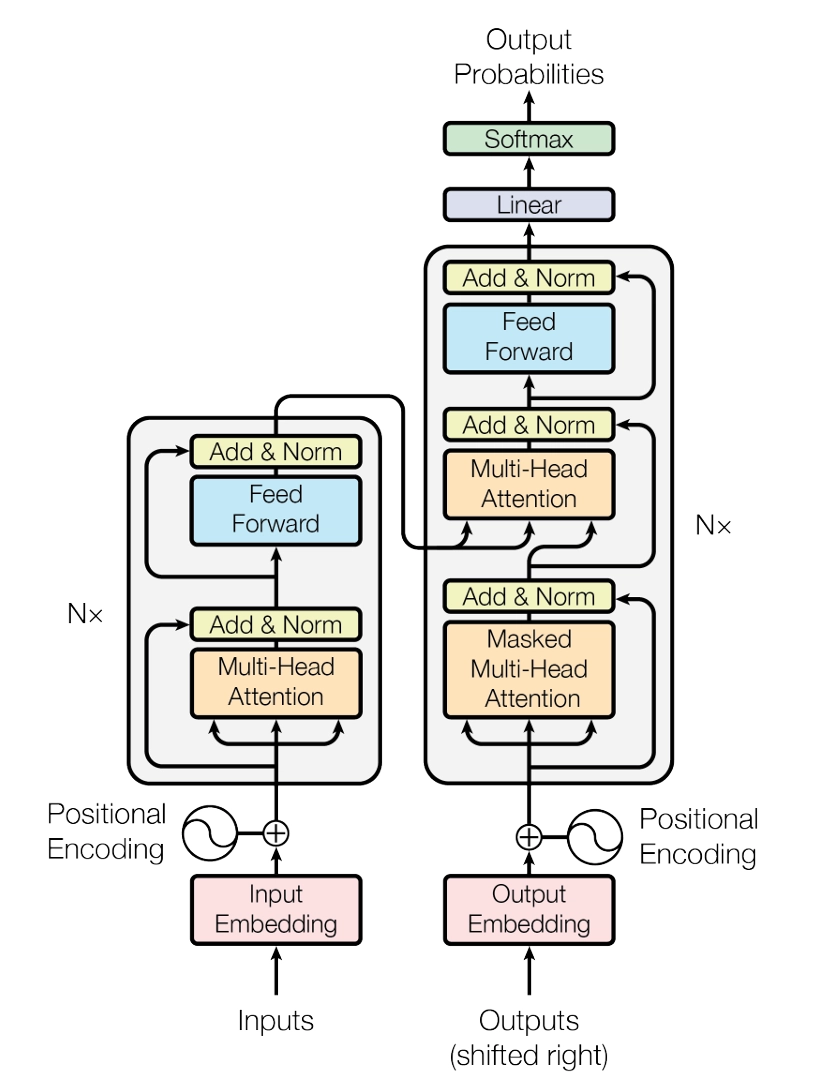
Figure 1: The Transformer - 모델 아키텍처.
Transformer는 이 전체적인 아키텍처를 따르며, encoder와 decoder 모두에 대해 쌓인 self-attention과 점별 완전 연결 계층을 사용해요. 이는 Figure 1의 왼쪽과 오른쪽 절반에 각각 보여져 있어요.
3.1 Encoder와 Decoder 스택
Encoder: encoder는 N = 6개의 동일한 레이어로 구성된 스택으로 이루어져 있어요. 각 레이어는 두 개의 서브 레이어를 가지고 있답니다. 첫 번째는 multi-head self-attention 메커니즘이고, 두 번째는 간단한 위치별 완전 연결 피드포워드 네트워크예요. 우리는 각 서브 레이어 주위에 residual connection [11]을 사용하고, 그 뒤에 layer normalization [1]을 적용해요. 즉, 각 서브 레이어의 출력은 LayerNorm(a + Sublayer(x))로, 여기서 Sublayer(x)는 서브 레이어 자체가 구현하는 함수랍니다. 이러한 residual connection을 용이하게 하기 위해, 모델의 모든 서브 레이어와 임베딩 레이어는 ᵈₘₒᵈₑₗ = 512 차원의 출력을 생성해요.
디코더: 디코더도 N = 6개의 동일한 레이어로 구성된 스택으로 이루어져 있어요. 각 인코더 레이어에 있는 두 개의 서브 레이어 외에도, 디코더는 인코더 스택의 출력을 대상으로 멀티-헤드 어텐션을 수행하는 세 번째 서브 레이어를 추가해요. 인코더와 마찬가지로, 각 서브 레이어 주위에 residual connections를 사용하고, 그 뒤에 레이어 정규화를 적용합니다. 또한, 디코더 스택의 self-attention 서브 레이어를 수정해서, 특정 위치가 이후의 위치에 주의를 기울이지 않도록 해요. 이 마스킹은 출력 임베딩이 한 위치씩 오프셋되는 것과 결합되어, 위치 i에 대한 예측이 i보다 작은 위치에서의 알려진 출력에만 의존할 수 있도록 보장해요.
3.2 어텐션
어텐션 함수는 쿼리와 키-값 쌍의 집합을 출력으로 매핑하는 것으로 설명할 수 있어요. 여기서 쿼리, 키, 값, 출력은 모두 벡터입니다. 출력은 가중치가 적용된 합으로 계산돼요.
스케일드 닷-프로덕트 어텐션
멀티-헤드 어텐션
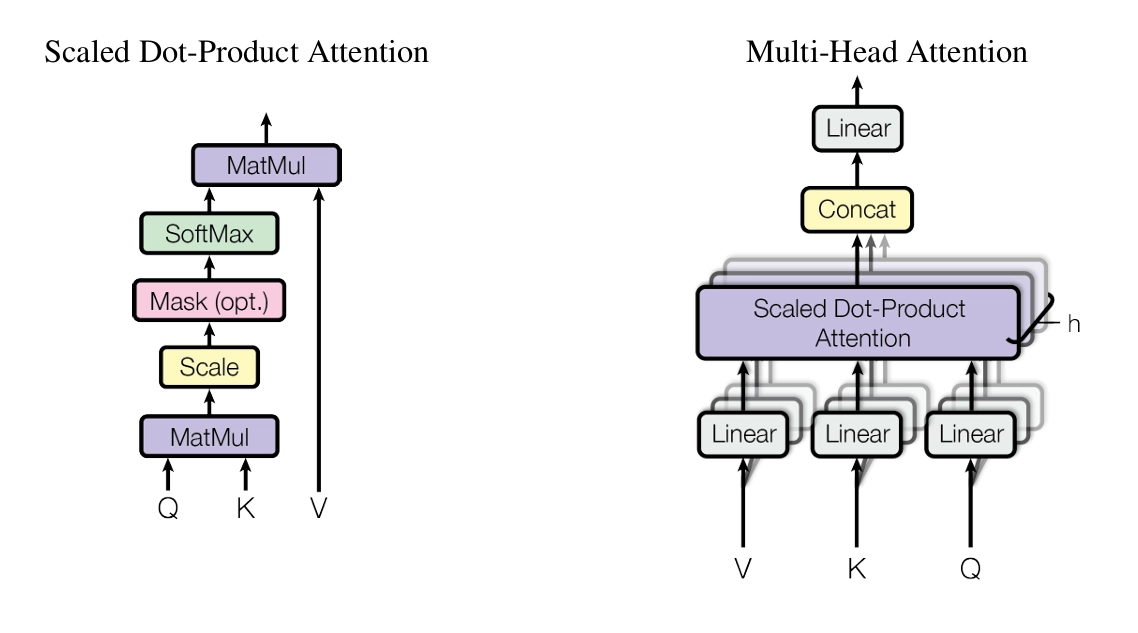
그림 2: (왼쪽) Scaled Dot-Product Attention. (오른쪽) Multi-Head Attention은 여러 개의 attention 레이어가 병렬로 실행되는 구조입니다.
값들에 할당되는 가중치는 쿼리와 해당 키의 호환성 함수에 의해 계산됩니다.
3.2.1 Scaled Dot-Product Attention
우리는 이 특별한 attention을 "Scaled Dot-Product Attention"이라고 부릅니다 (그림 2). 입력은 차원이 dₖ인 쿼리와 키, 그리고 차원이 dᵥ인 값들로 구성됩니다. 쿼리와 모든 키의 내적을 계산하고, 각각을 √σₖ로 나눈 후, softmax 함수를 적용하여 값들에 대한 가중치를 얻습니다.
실제로는, 여러 쿼리에 대해 동시에 attention 함수를 계산해요. 이 쿼리들은 행렬 Q로 묶여 있습니다. 키와 값들도 각각 행렬 K와 V로 묶여 있답니다. 출력 행렬은 다음과 같이 계산합니다:
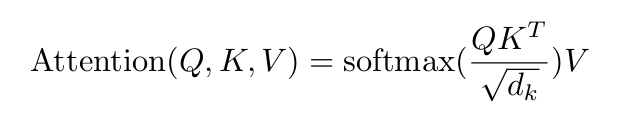
가장 흔히 사용되는 두 가지 attention 함수는 additive attention [2]과 dot-product (multiplicative) attention이에요. Dot-product attention은 1/√dₖ의 스케일링 팩터를 제외하면 우리 알고리즘과 동일하답니다. Additive attention은 단일 hidden layer를 가진 feed-forward 네트워크를 사용해서 호환성 함수를 계산해요. 이 두 가지는 이론적으로 복잡도가 비슷하지만, dot-product attention은 고도로 최적화된 행렬 곱셈 코드를 사용할 수 있어서 실제로는 훨씬 빠르고 공간 효율적이에요.
dₖ의 값이 작을 때는 두 메커니즘이 비슷하게 작동하지만, dₖ의 값이 클 때는 additive attention이 스케일링 없는 dot-product attention보다 더 잘 작동해요 [3]. 우리는 dₖ의 값이 클 때 dot-product의 크기가 커져서 softmax 함수가 매우 작은 기울기를 가지는 영역으로 밀려난다고 추측해요. 이 효과를 상쇄하기 위해, 우리는 dot-product를 1/√dₖ로 스케일링해요.
3.2.2 Multi-Head Attention
dmodel 차원의 키, 값, 쿼리를 사용해 단일 attention 함수를 수행하는 대신, 쿼리, 키, 값을 각각 dₖ, dₖ, dv 차원으로 h번 선형 투영하는 것이 유익하다는 것을 발견했어요. 이렇게 투영된 쿼리, 키, 값의 각 버전에 대해 병렬로 attention 함수를 수행해서 d₁ 차원의 결과를 얻어요.
dot-product가 커지는 이유를 설명하기 위해, q와 k의 구성 요소가 평균 0, 분산 1인 독립적인 랜덤 변수라고 가정해 보세요. 그러면 그들의 dot-product, q k = qᵢkᵢ는 평균 0, 분산 dₖ를 가지게 돼요.
출력 값들은 이어 붙여지고, 다시 한번 투영되어 최종 값이 만들어져요. 이 과정은 그림 2에 나와 있어요.
Multi-head attention은 모델이 서로 다른 표현 하위 공간에서 다양한 위치의 정보를 동시에 주목할 수 있게 해줘요. 단일 attention head를 사용할 경우, 평균화가 이를 방해하거든요.
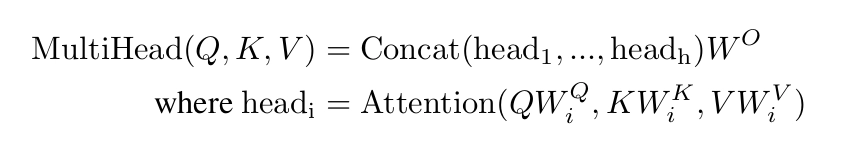
Where the projections are parameter matrices Wᵢ E ᵈₘₒᵈₑₗ Wᵢᵏ E dₘ₀del WᵢV αₘₒᵈₑₗ dᵥ and W° E hdᵥ
이번 연구에서는 h = 8개의 병렬 attention layer, 즉 head를 사용해요. 각 head에 대해 dₖ = dᵥ = dₘ₀de₁/h = 64를 사용합니다. 각 head의 차원이 줄어들기 때문에, 전체 계산 비용은 전체 차원을 사용하는 단일 head attention과 비슷해요.
3.2.3 Applications of Attention in our Model
Transformer는 multi-head attention을 세 가지 다른 방식으로 사용해요.
"encoder-decoder attention" 레이어에서는 queries가 이전 decoder 레이어에서 오고, memory keys와 values는 encoder의 출력에서 와요. 이렇게 하면 decoder의 모든 위치가 입력 시퀀스의 모든 위치에 주의를 기울일 수 있게 되죠. 이는 [38, 2, 9]과 같은 sequence-to-sequence 모델에서의 일반적인 encoder-decoder attention 메커니즘을 모방한 것이랍니다.
encoder에는 self-attention 레이어가 포함되어 있어요. self-attention 레이어에서는 keys, values, queries가 모두 같은 곳에서 오는데, 이 경우 encoder의 이전 레이어 출력에서 오게 됩니다. encoder의 각 위치는 encoder의 이전 레이어의 모든 위치에 주의를 기울일 수 있어요.
마찬가지로, decoder의 self-attention 레이어는 decoder의 각 위치가 그 위치까지 포함하여 decoder의 모든 위치에 주의를 기울일 수 있게 해줘요. decoder에서 왼쪽으로 정보가 흐르는 것을 막아야 auto-regressive 특성을 유지할 수 있답니다. 이를 위해 scaled dot-product attention 안에서 softmax 입력의 불법 연결에 해당하는 모든 값을 마스킹하여 -∞로 설정해요. Figure 2를 참고하세요.
3.3 Position-wise Feed-Forward Networks
attention 서브 레이어 외에도, encoder와 decoder의 각 레이어에는 완전히 연결된 feed-forward network가 포함되어 있어요. 이는 각 위치에 개별적으로 동일하게 적용됩니다. 이 네트워크는 두 개의 선형 변환과 그 사이에 ReLU 활성화 함수로 구성되어 있어요.
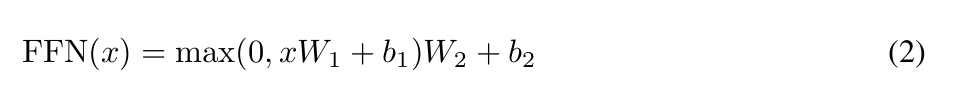
선형 변환은 서로 다른 위치에서 동일하지만, 층마다 다른 매개변수를 사용해요. 이를 설명하는 또 다른 방법은 커널 크기가 1인 두 개의 컨볼루션으로 보는 거예요. 입력과 출력의 차원은 ᵈₘₒᵈₑₗ = 512이고, 내부 층의 차원은 dƒƒ = 2048이에요.
3.4 Embeddings and Softmax
다른 시퀀스 변환 모델과 마찬가지로, 입력 토큰과 출력 토큰을 ᵈₘₒᵈₑₗ 차원의 벡터로 변환하기 위해 학습된 임베딩을 사용해요. 또한, 디코더 출력을 예측된 다음 토큰 확률로 변환하기 위해 일반적인 학습된 선형 변환과 소프트맥스 함수를 사용해요. 우리 모델에서는 두 임베딩 층과 소프트맥스 전 선형 변환 사이에 동일한 가중치 행렬을 공유해요, [30]과 유사하게요. 임베딩 층에서는 그 가중치를 Vᵈₘₒᵈₑₗ로 곱해요.
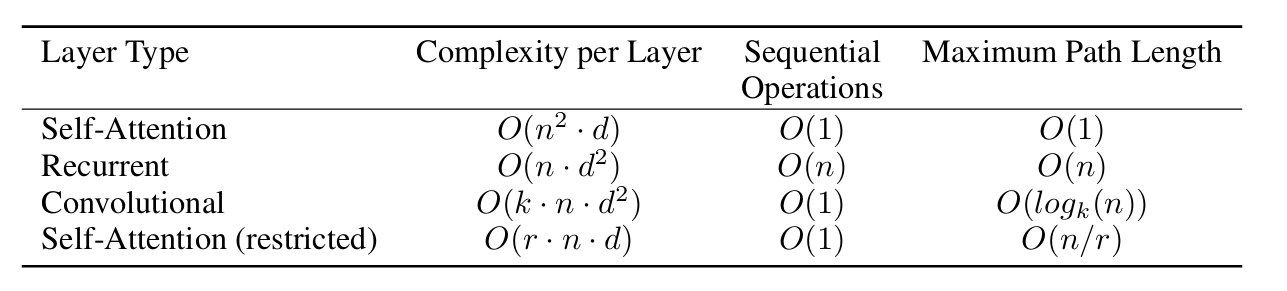
표 1: 서로 다른 층 유형에 대한 최대 경로 길이, 층별 복잡도 및 최소 순차 연산 수. n은 시퀀스 길이, d는 표현 차원, k는 컨볼루션의 커널 크기, r은 제한된 자기 주의의 이웃 크기입니다.
3.5 Positional Encoding
우리 모델은 recurrence와 convolution이 없기 때문에, 시퀀스의 순서를 활용하려면 시퀀스 내 토큰의 상대적 또는 절대적 위치에 대한 정보를 주입해야 해요. 이를 위해, 인코더와 디코더 스택의 하단에 있는 입력 임베딩에 "positional encodings"를 추가합니다. 이 positional encodings는 임베딩과 같은 차원 ᵈₘₒᵈₑₗ을 가지므로, 두 개를 합할 수 있어요. positional encodings는 학습된 것과 고정된 것 등 여러 가지 선택지가 있답니다 [9].
이번 연구에서는 서로 다른 주파수의 사인과 코사인 함수를 사용해요.
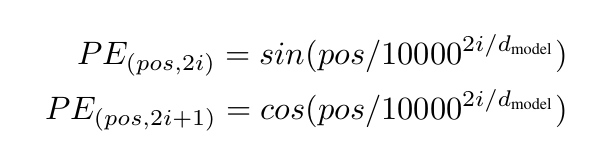
여기서 pos는 위치이고 i는 차원이에요. 즉, positional encoding의 각 차원은 사인파에 해당해요. 파장의 길이는 2π에서 10000 2π까지 기하급수적으로 증가해요. 이 함수를 선택한 이유는, 모델이 상대적인 위치에 따라 쉽게 주의를 기울일 수 있도록 할 것이라고 가정했기 때문이에요. 고정된 오프셋 k에 대해, PEₚ₀ₛ₊ₖ는 PEₚ₀ₛ의 선형 함수로 표현될 수 있거든요.
학습된 positional embeddings를 대신 사용하는 실험도 해봤는데, 두 버전이 거의 동일한 결과를 낸다는 것을 발견했어요 (Table 3의 (E) 행을 보세요). 우리는 모델이 학습 중에 접한 것보다 더 긴 시퀀스 길이로 외삽할 수 있을 것 같아서 사인파 버전을 선택했답니다.
4 WhySelf-Attention?
이 섹션에서는 self-attention 레이어와 일반적으로 사용되는 recurrent 및 convolutional 레이어를 비교해 볼 거예요. 이 레이어들은 보통 하나의 가변 길이 시퀀스의 심볼 표현(x₁, xₙ)을 동일한 길이의 다른 시퀀스(z₁, zₙ)로 매핑하는 데 사용되죠. 예를 들어, 일반적인 시퀀스 변환 인코더나 디코더의 숨겨진 레이어 같은 경우요. self-attention을 사용하는 이유를 설명하기 위해 세 가지 기준을 고려해요.
첫 번째는 레이어당 총 계산 복잡도예요. 두 번째는 병렬화할 수 있는 계산량인데, 이는 필요한 최소한의 순차적 연산 수로 측정해요.
세 번째는 네트워크에서 장거리 의존성 간의 경로 길이예요. 장거리 의존성을 학습하는 것은 많은 시퀀스 변환 작업에서 중요한 도전 과제랍니다. 이러한 의존성을 학습하는 능력에 영향을 미치는 주요 요소 중 하나는 네트워크에서 신호가 앞으로 가고 뒤로 가야 하는 경로의 길이예요. 입력과 출력 시퀀스의 어떤 위치 조합 간의 경로가 짧을수록 장거리 의존성을 학습하기가 더 쉬워요 [12]. 그래서 우리는 서로 다른 레이어 유형으로 구성된 네트워크에서 어떤 두 입력과 출력 위치 간의 최대 경로 길이도 비교해요.
표 1에서 알 수 있듯이, self-attention 레이어는 일정한 수의 순차적으로 실행되는 연산으로 모든 위치를 연결해요. 반면에 recurrent 레이어는 O(n)의 순차적 연산이 필요하죠. 계산 복잡도 측면에서 보면, self-attention 레이어는 시퀀스가
길이 n이 표현 차원 d보다 작아요. 이는 주로 최신 기계 번역 모델에서 사용되는 문장 표현에서 자주 발생하는데요, 예를 들어 word-piece [38]나 byte-pair [31] 표현 같은 것들이죠. 아주 긴 시퀀스를 다루는 작업에서 계산 성능을 향상시키기 위해, self-attention을 입력 시퀀스의 특정 출력 위치를 중심으로 한 크기 r의 이웃만 고려하도록 제한할 수 있어요. 이렇게 하면 최대 경로 길이가 O(n/r)로 늘어나게 됩니다. 이 접근법을 향후 연구에서 더 조사해 볼 계획이에요.
커널 너비 k < n인 단일 컨볼루션 레이어는 모든 입력과 출력 위치 쌍을 연결하지 않아요. 이를 위해서는 연속 커널의 경우 O(n/k) 개의 컨볼루션 레이어가 필요하고, 확장된 컨볼루션의 경우 O(logₖ(n))가 필요해요 [18]. 이는 네트워크 내의 어떤 두 위치 사이의 가장 긴 경로 길이를 증가시킵니다. 일반적으로 컨볼루션 레이어는 반복 레이어보다 k배 더 비싸요. 하지만 분리 가능한 컨볼루션 [6]은 복잡성을 상당히 줄여서 O(k n d + n d²)로 만들어요. k = n인 경우에도, 분리 가능한 컨볼루션의 복잡성은 self-attention 레이어와 point-wise feed-forward 레이어를 결합한 것과 같아요. 이 접근법이 우리 모델에서 사용하는 방법이랍니다.
부수적인 이점으로, self-attention은 더 해석 가능한 모델을 제공할 수 있어요. 우리 모델에서의 attention 분포를 살펴보고, 부록에서 예시를 제시하고 논의해요. 개별 attention head들이 명확히 다른 작업을 수행하도록 학습할 뿐만 아니라, 많은 경우 문장의 구문 및 의미 구조와 관련된 행동을 보이는 것 같아요.
5 Training
이 섹션에서는 우리 모델의 학습 체제를 설명합니다.
5.1 학습 데이터와 배칭
우리는 약 450만 개의 문장 쌍으로 구성된 표준 WMT 2014 영어-독일어 데이터셋을 사용해 학습했어요. 문장은 byte-pair encoding [3]을 사용해 인코딩했는데, 약 37000개의 토큰으로 이루어진 공유된 소스-타겟 어휘를 가지고 있어요. 영어-프랑스어의 경우, 훨씬 더 큰 규모인 3600만 개의 문장으로 구성된 WMT 2014 영어-프랑스어 데이터셋을 사용했고, 토큰을 32000개의 word-piece 어휘로 나누었어요 [38]. 문장 쌍은 대략적인 시퀀스 길이에 따라 배치되었고, 각 학습 배치는 약 25000개의 소스 토큰과 25000개의 타겟 토큰을 포함했어요.
5.2 하드웨어와 일정
우리는 8개의 NVIDIA P100 GPU가 장착된 한 대의 머신에서 모델을 학습했어요. 논문 전반에 걸쳐 설명된 하이퍼파라미터를 사용하는 기본 모델의 경우, 각 학습 단계는 약 0.4초가 걸렸어요. 기본 모델은 총 100,000단계, 즉 12시간 동안 학습했어요. 큰 모델의 경우 (표 3의 마지막 줄에 설명되어 있어요), 단계 시간은 1.0초였어요. 큰 모델은 300,000단계, 즉 3.5일 동안 학습했답니다.
5.3 옵티마이저
우리는 Adam 옵티마이저 [20]를 사용했어요. ß₁ = 0.9, ß₂ = 0.98, € = 10⁻⁹로 설정했답니다. 학습 과정에서 학습률은 다음 공식에 따라 변동시켰어요:
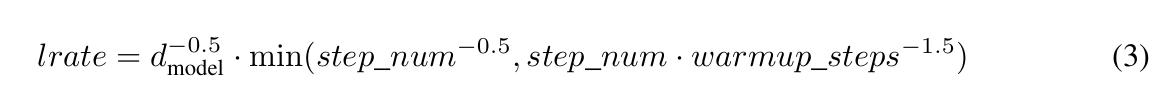
이것은 처음 warmup_steps 동안 학습률을 선형적으로 증가시키고, 그 이후에는 step 수의 역제곱근에 비례하여 감소시키는 것을 의미해요. 우리는 warmup_steps를 4000으로 설정했어요.
5.4 정규화
훈련 중에 세 가지 유형의 정규화를 사용해요.
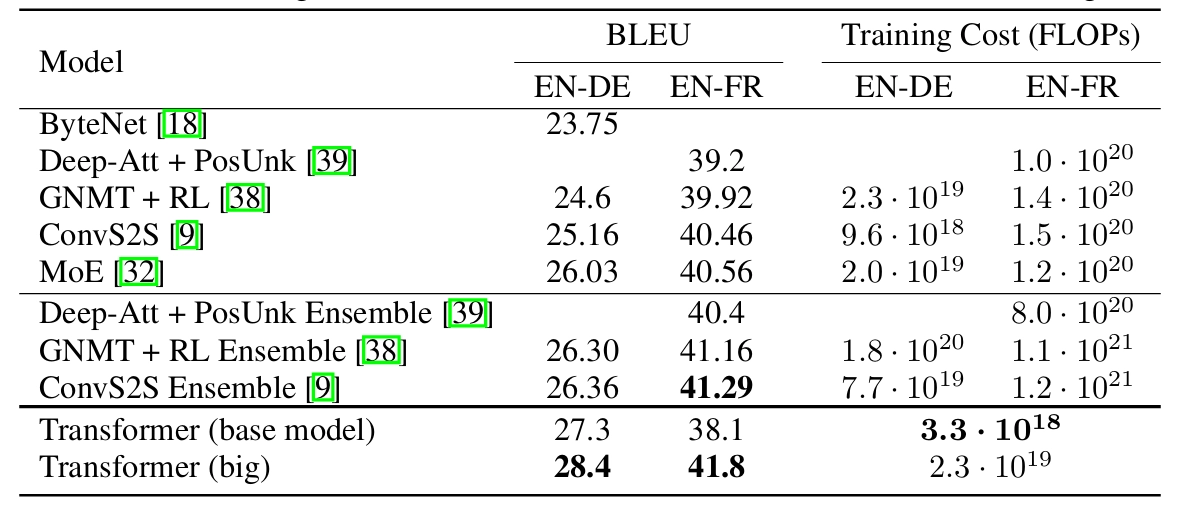
표 2: Transformer는 영어-독일어 및 영어-프랑스어 newstest2014 테스트에서 이전 최첨단 모델들보다 더 나은 BLEU 점수를, 훈련 비용의 일부만으로 달성했어요.
Residual Dropout에서는 각 서브 레이어의 출력에 dropout [33]을 적용해요. 이 출력은 서브 레이어 입력에 더해지고 정규화되기 전에 적용되죠. 또한, encoder와 decoder 스택에서 임베딩과 positional encodings의 합에도 dropout을 적용해요. 기본 모델에서는 Pdᵣₒₚ = 0.1의 비율을 사용합니다.
Label Smoothing에서는 훈련 중에 εₗₛ = 0.1 [36]의 값을 사용한 label smoothing을 적용했어요. 이로 인해 perplexity는 증가하지만, 모델이 더 불확실하게 학습되면서 정확도와 BLEU 점수는 향상됩니다.
6 Results
6.1 Machine Translation
WMT 2014 영어-독일어 번역 과제에서, 큰 transformer 모델(표 2의 Transformer (big))은 이전에 보고된 최고의 모델들(앙상블 포함)을 2.0 BLEU 이상으로 능가하며, 28.4라는 새로운 최고 BLEU 점수를 기록했어요. 이 모델의 구성은 표 3의 마지막 줄에 나와 있습니다. 훈련은 8개의 P100 GPU에서 3.5일이 걸렸어요. 심지어 우리 기본 모델도 모든 이전에 발표된 모델과 앙상블을 능가하며, 경쟁 모델의 훈련 비용의 일부만으로도 뛰어납니다.
WMT 2014 영어-프랑스어 번역 과제에서, 우리 큰 모델은 41.0의 BLEU 점수를 기록하며, 이전에 발표된 모든 단일 모델을 능가했어요. 영어-프랑스어 번역을 위해 훈련된 Transformer (big) 모델은 dropout 비율 Pdrop = 0.1을 사용했으며, 0.3 대신 사용했어요.
기본 모델의 경우, 10분 간격으로 기록된 마지막 5개의 체크포인트를 평균 내어 단일 모델을 사용했어요. 큰 모델의 경우, 마지막 20개의 체크포인트를 평균 냈습니다. 빔 크기 4와 길이 패널티 α = 0.6 [38]를 사용한 빔 서치를 사용했어요. 이러한 하이퍼파라미터는 개발 세트에서 실험 후 선택되었어요. 추론 중 최대 출력 길이는 입력 길이 + 50으로 설정했지만, 가능한 경우 조기에 종료합니다 [38].
Table 2는 우리 결과를 요약하고, 다른 문헌에 있는 모델 아키텍처와 비교하여 번역 품질과 학습 비용을 보여줘요. 모델을 학습시키는 데 사용된 부동 소수점 연산의 수는 학습 시간, 사용된 GPU의 수, 각 GPU의 지속적인 단정밀도 부동 소수점 용량의 추정치를 곱해서 추정해요.
6.2 모델 변형
Transformer의 다양한 구성 요소의 중요성을 평가하기 위해, 우리는 기본 모델을 여러 방식으로 변형시켜서 영어-독일어 번역 성능의 변화를 측정했어요.
Table 3: Transformer 아키텍처의 변형. 나열되지 않은 값들은 기본 모델과 동일해요. 모든 지표는 영어-독일어 번역 개발 세트인 newstest2013에서 측정했어요. 나열된 perplexity는 byte-pair encoding에 따른 단어 조각당 수치이며, 단어당 perplexity와 비교하면 안 돼요.
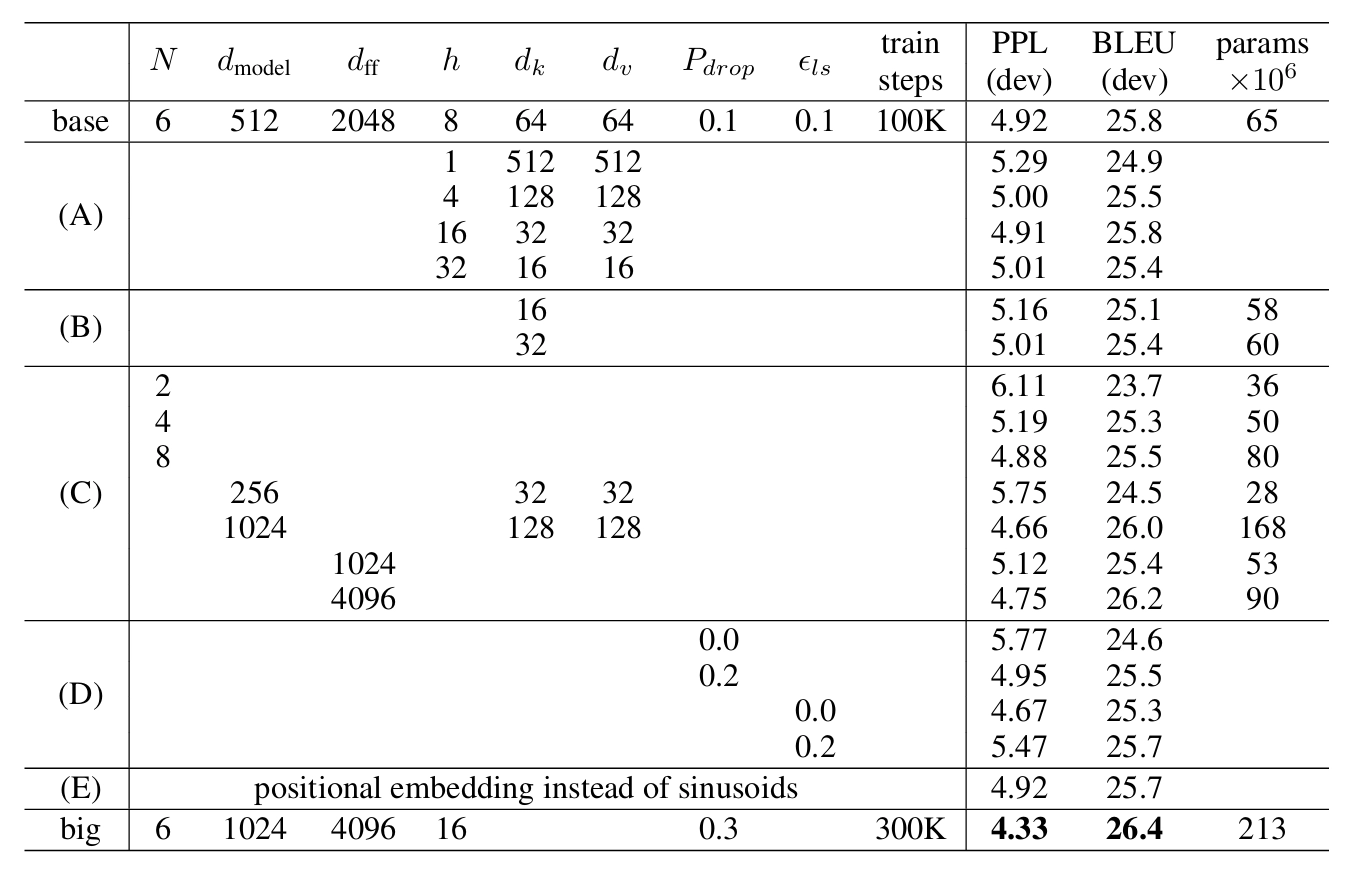
개발 세트인 newstest2013에서 측정했어요. 이전 섹션에서 설명한 대로 beam search를 사용했지만, 체크포인트 평균화는 하지 않았어요. 이 결과는 Table 3에 제시되어 있어요.
표 3의 (A) 행에서는, Section 3.2.2에서 설명한 대로 계산량을 일정하게 유지하면서 attention head의 수와 attention key 및 value의 차원을 다양하게 조정했어요. single-head attention은 최적 설정보다 BLEU 점수가 0.9 낮았고, head가 너무 많아도 품질이 떨어지더라고요.
표 3의 (B) 행에서는 attention key 크기 dₖ를 줄이면 모델 품질이 떨어진다는 것을 관찰했어요. 이는 호환성을 결정하는 것이 쉽지 않으며, dot product보다 더 정교한 호환성 함수가 유용할 수 있음을 시사해요. (C)와 (D) 행에서는 예상대로 더 큰 모델이 더 좋고, dropout이 과적합을 피하는 데 매우 도움이 된다는 것을 추가로 관찰했어요. (E) 행에서는 우리의 사인파 positional encoding을 학습된 positional embeddings [9]로 대체했는데, 기본 모델과 거의 동일한 결과를 얻었어요.
6.3 영어 구성 구문 분석
Transformer가 다른 작업으로 일반화할 수 있는지 평가하기 위해 영어 구성 구문 분석 실험을 수행했어요. 이 작업은 특정한 도전 과제를 제시하는데, 출력이 강한 구조적 제약을 받으며 입력보다 훨씬 길어요. 게다가, RNN sequence-to-sequence 모델은 작은 데이터 환경에서 최첨단 결과를 달성하지 못했어요 [37].
우리는 Penn Treebank의 Wall Street Journal (WSJ) 부분에서 dₘₒdel = 1024인 4-layer transformer를 약 40K개의 훈련 문장으로 학습했어요 [25]. 또한, 약 1700만 개의 문장이 있는 더 큰 high-confidence와 BerkleyParser 코퍼스를 사용하여 반지도 학습 설정에서도 학습했어요 [37]. WSJ 전용 설정에서는 16K 토큰의 어휘를 사용했고, 반지도 학습 설정에서는 32K 토큰의 어휘를 사용했답니다.
우리는 dropout, attention, residual (섹션 5.4), 학습률, 그리고 beam size를 Section 22 개발 세트에서 선택하기 위해 소수의 실험만 수행했어요. 다른 모든 파라미터는 영어-독일어 기본 번역 모델에서 변경되지 않았답니다. 추론 시에는,
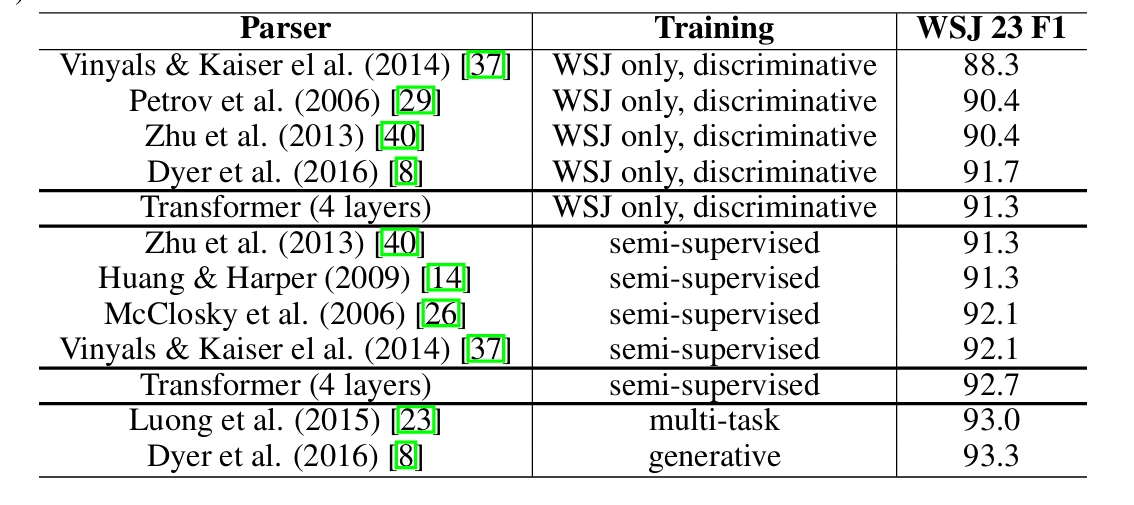
표 4: Transformer는 영어 구성 구문 분석에 잘 일반화됩니다 (결과는 WSJ의 Section 23에서 나왔어요).
최대 출력 길이를 입력 길이 + 300으로 늘렸어요. 그리고 beam size는 21, α는 0.3을 WSJ만 사용한 경우와 반지도 학습 설정 모두에 적용했어요.
표 4의 결과를 보면, 특정 작업에 맞춘 튜닝이 없었음에도 불구하고 우리 모델이 놀랍도록 잘 작동한다는 것을 알 수 있어요. Recurrent Neural Network Grammar [8]을 제외한 모든 이전 모델보다 더 나은 결과를 보여주었답니다.
RNN sequence-to-sequence 모델 [37]과 달리, Transformer는 WSJ 훈련 세트의 40K 문장만으로 학습했을 때도 BerkeleyParser [29]보다 더 뛰어난 성능을 발휘해요.
7 Conclusion
이번 연구에서는 Transformer를 소개했어요. 이 모델은 전적으로 attention에 기반한 최초의 sequence transduction 모델로, encoder-decoder 구조에서 흔히 사용되던 recurrent layers를 multi-headed self-attention으로 대체했답니다.
번역 작업에서는 Transformer가 recurrent나 convolutional layers 기반의 구조보다 훨씬 빠르게 학습할 수 있어요. WMT 2014 영어-독일어와 영어-프랑스어 번역 작업 모두에서 새로운 최고 성능을 달성했답니다. 특히 전자의 경우, 우리의 최고 모델은 이전에 보고된 모든 앙상블을 능가했어요.
attention 기반 모델의 미래가 기대되고, 이를 다른 작업에도 적용할 계획이에요. Transformer를 텍스트 이외의 입력 및 출력 모달리티를 포함하는 문제로 확장하고, 이미지, 오디오, 비디오와 같은 큰 입력과 출력을 효율적으로 처리하기 위해 지역적이고 제한된 attention 메커니즘을 조사할 계획입니다. 생성 과정을 덜 순차적으로 만드는 것도 우리의 연구 목표 중 하나랍니다.
우리 모델을 학습하고 평가하는 데 사용한 코드는 https://github.com/ tensorflow/tensor2tensor에서 확인할 수 있어요.
감사의 말씀 Nal Kalchbrenner와 Stephan Gouws에게 유익한 의견과 수정, 영감을 주셔서 감사드립니다.
Attention 시각화
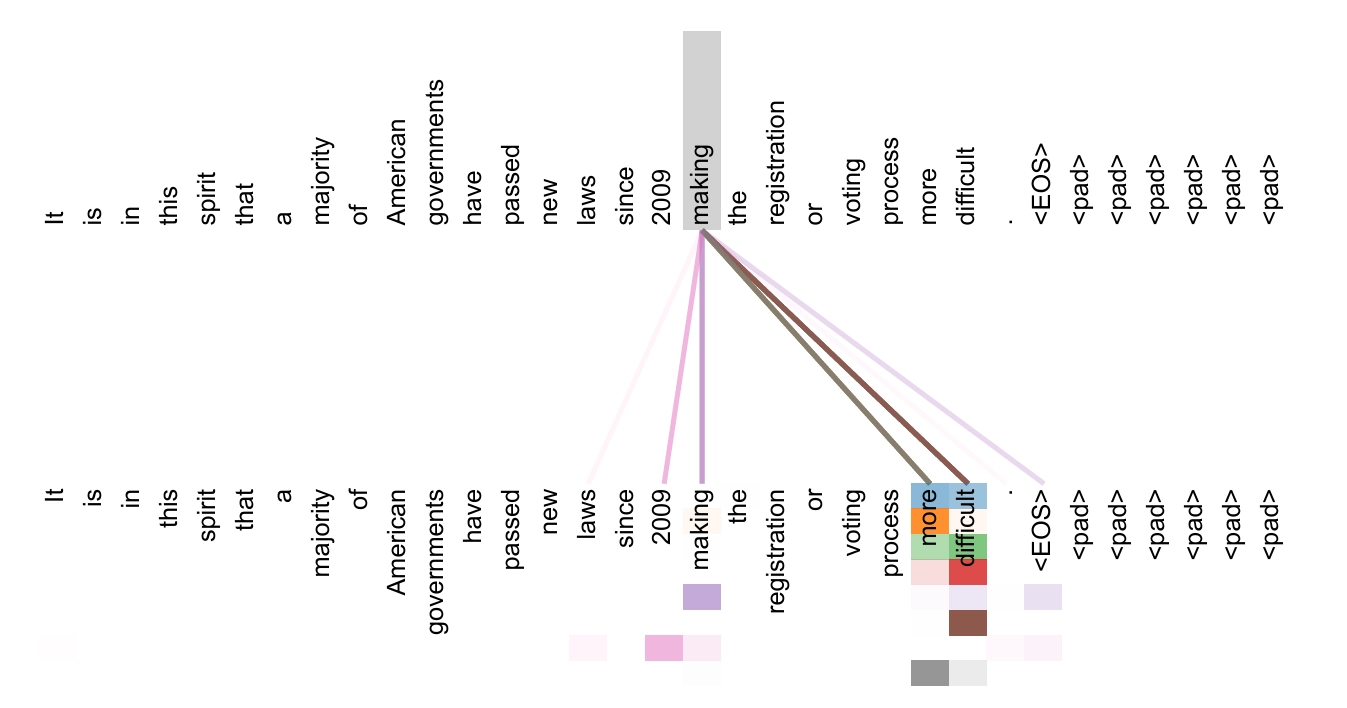
그림 3: 6개의 레이어 중 5번째 레이어의 인코더 self-attention에서 장거리 의존성을 따르는 attention 메커니즘의 예시입니다. 많은 attention head들이 동사 'making'의 먼 의존성에 주목하여 "making more difficult"라는 구문을 완성합니다. 여기서는 'making'이라는 단어에 대한 attention만 보여줍니다. 다른 색상은 다른 head를 나타내며, 컬러로 보는 것이 가장 좋습니다.
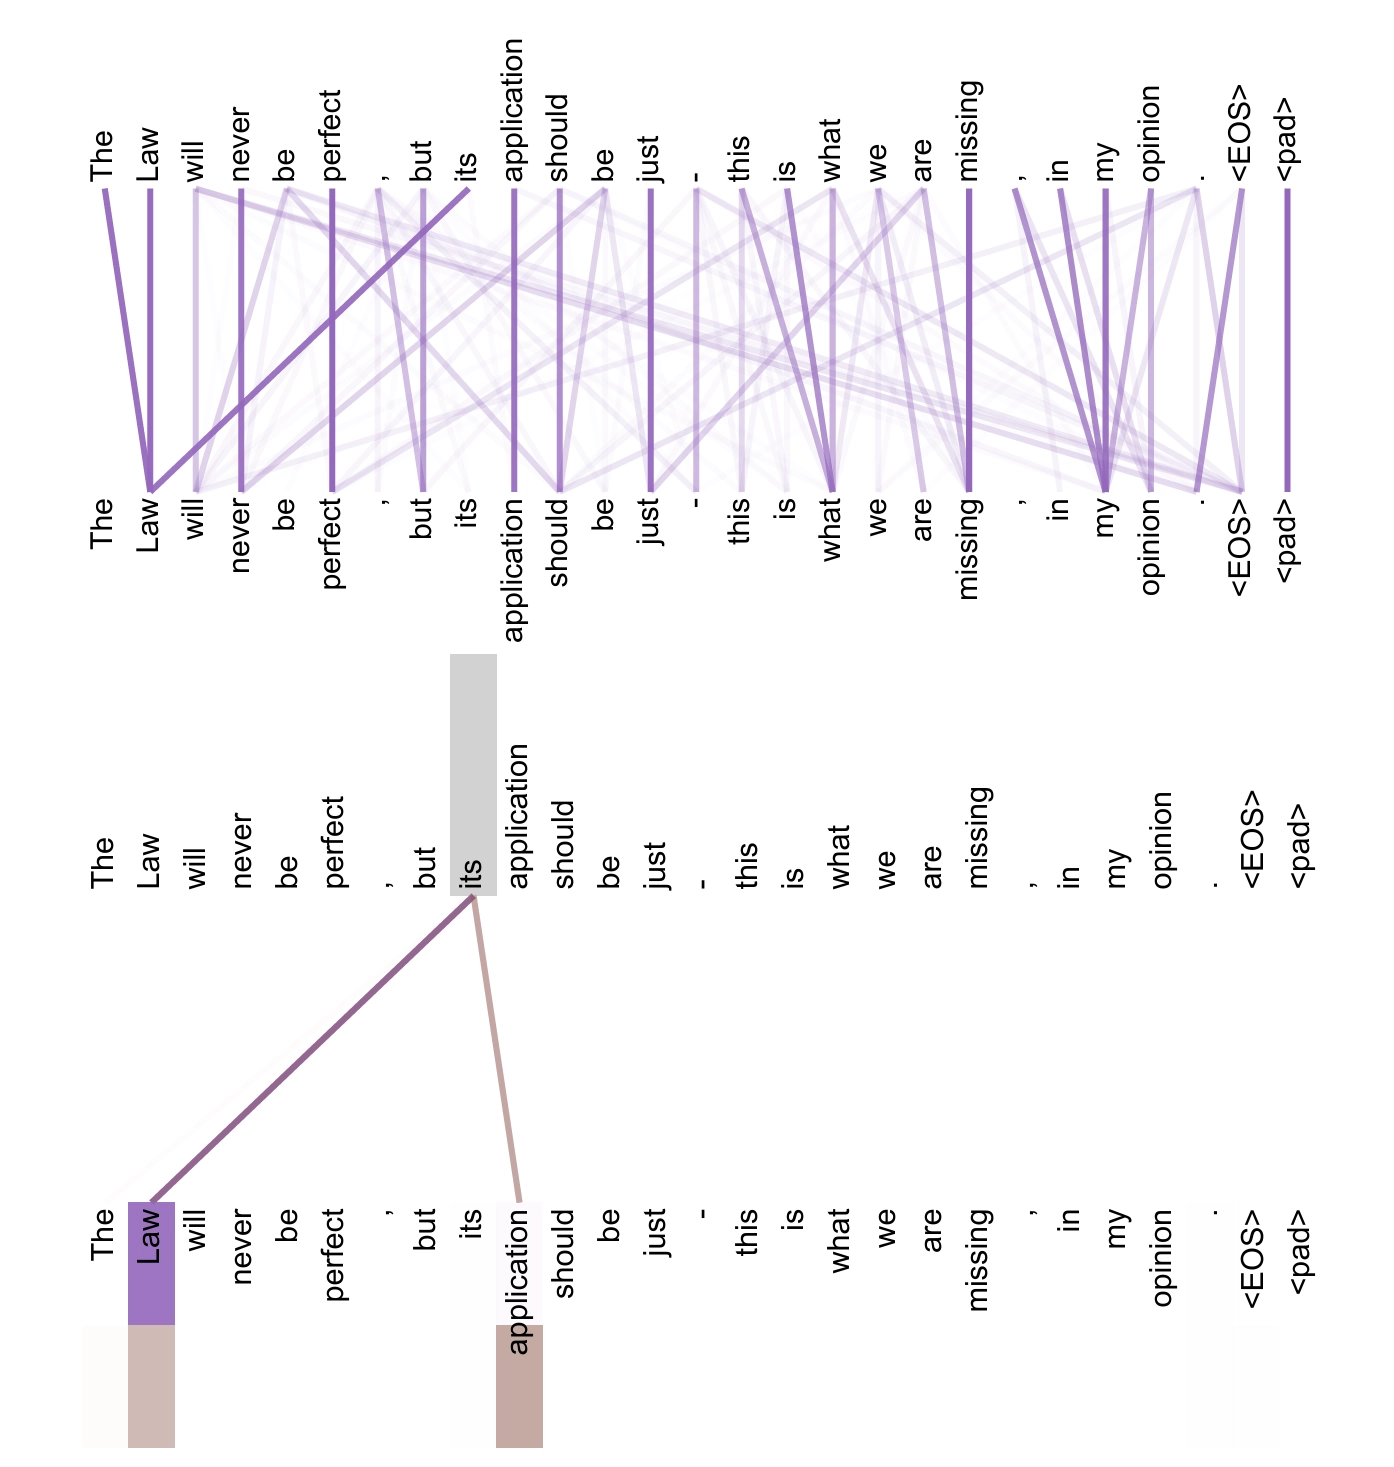
그림 4: 6개의 레이어 중 5번째 레이어에 있는 두 개의 attention head가 대명사 해석에 관여하는 것으로 보입니다. 위: head 5의 전체 attention. 아래: 'its'라는 단어에 대한 head 5와 6의 고립된 attention입니다. 이 단어에 대한 attention이 매우 뚜렷하다는 점에 주목하세요.
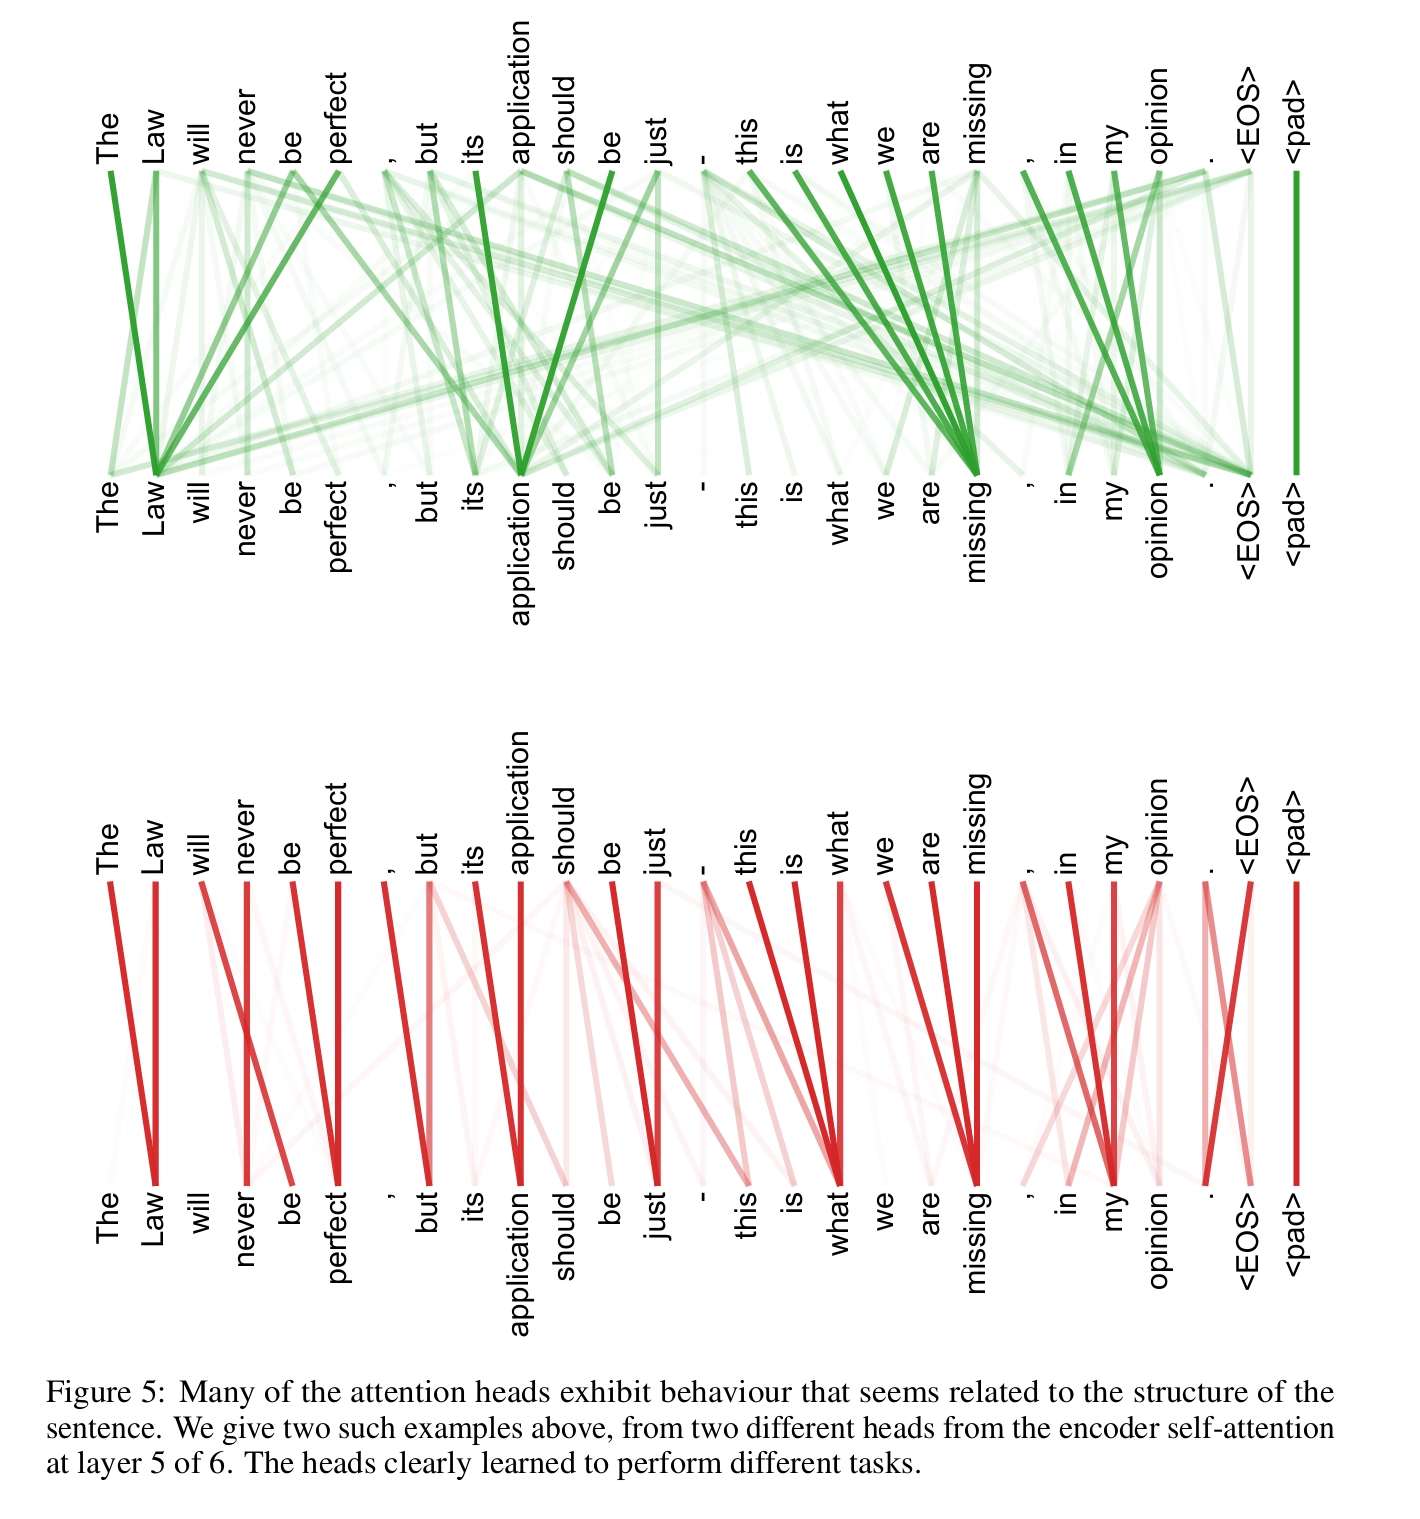
그림 5: 많은 attention head들이 문장의 구조와 관련된 행동을 보입니다. 위에는 6개의 레이어 중 5번째 레이어의 인코더 self-attention에서 두 개의 다른 head의 예시를 보여줍니다. 이 head들은 명확히 서로 다른 작업을 수행하도록 학습되었습니다.
References
[1] Jimmy Lei Ba, Jamie Ryan Kiros, 그리고 Geoffrey E Hinton. Layer normalization. arXiv preprint arXiv:1607.06450, 2016.
[2] Dzmitry Bahdanau, Kyunghyun Cho, 그리고 Yoshua Bengio. Neural machine translation by jointly learning to align and translate. CoRR, abs/1409.0473, 2014.
[3] Denny Britz, Anna Goldie, Minh-Thang Luong, 그리고 Quoc V. Le. Massive exploration of neural machine translation architectures. CoRR, abs/1703.03906, 2017.
[4] Jianpeng Cheng, Li Dong, 그리고 Mirella Lapata. Long short-term memory-networks for machine reading. arXiv preprint arXiv: 1601.06733, 2016.
[5] Kyunghyun Cho, Bart van Merrienboer, Caglar Gulcehre, Fethi Bougares, Holger Schwenk, 그리고 Yoshua Bengio. Learning phrase representations using rnn encoder-decoder for statistical machine translation. CoRR, abs/1406.1078, 2014.
[6] Francois Chollet. Xception: Depthwise separable convolutions를 활용한 딥러닝. arXiv preprint 1610.02357, 2016.
[7] Junyoung Chung, Çaglar Gülçehre, Kyunghyun Cho, 그리고 Yoshua Bengio. 시퀀스 모델링에서 게이트 순환 신경망의 실증적 평가. CoRR, abs/1412.3555, 2014.
[8] Chris Dyer, Adhiguna Kuncoro, Miguel Ballesteros, 그리고 Noah A. Smith. 순환 신경망 문법. NAACL의 Proc.에서, 2016.
[9] Jonas Gehring, Michael Auli, David Grangier, Denis Yarats, 그리고 Yann N. Dauphin. 컨볼루션 시퀀스 투 시퀀스 학습. arXiv preprint arXiv:1705.03122v2, 2017.
[10] Alex Graves. 순환 신경망을 사용한 시퀀스 생성. arXiv preprint arXiv:1308.0850, 2013.
[11] Kaiming He, Xiangyu Zhang, Shaoqing Ren, 그리고 Jian Sun. 이미지 인식을 위한 딥 레지듀얼 학습. IEEE Computer Vision and Pattern Recognition Conference 논문집, 페이지 770-778, 2016.
[12] Sepp Hochreiter, Yoshua Bengio, Paolo Frasconi, 그리고 Jürgen Schmidhuber. 순환 신경망에서의 그래디언트 흐름: 장기 의존성 학습의 어려움, 2001.
[13] Sepp Hochreiter 그리고 Jürgen Schmidhuber. 장단기 메모리. Neural computation, 9(8):1735-1780, 1997.
[14] Zhongqiang Huang 그리고 Mary Harper. 잠재적 주석을 사용한 언어 간 자기 학습 PCFG 문법. 2009년 Empirical Methods in Natural Language Processing Conference 논문집, 페이지 832-841. ACL, 2009년 8월.
[15] Rafal Jozefowicz, Oriol Vinyals, Mike Schuster, Noam Shazeer, 그리고 Yonghui Wu. 언어 모델링의 한계 탐구. arXiv preprint arXiv: 1602.02410, 2016.
[16] Lukasz Kaiser와 Samy Bengio. Active memory가 attention을 대체할 수 있을까요? Advances in Neural Information Processing Systems (NIPS), 2016.
[17] Lukasz Kaiser와 Ilya Sutskever. Neural GPU가 알고리즘을 학습합니다. International Conference on Learning Representations (ICLR), 2016.
[18] Nal Kalchbrenner, Lasse Espeholt, Karen Simonyan, Aaron van den Oord, Alex Graves, 그리고 Koray Kavukcuoglu. 선형 시간에서의 신경 기계 번역. arXiv preprint arXiv: 1610.10099v2, 2017.
[19] Yoon Kim, Carl Denton, Luong Hoang, 그리고 Alexander M. Rush. Structured attention networks. International Conference on Learning Representations, 2017.
[20] Diederik Kingma and Jimmy Ba. Adam: A method for stochastic optimization. In ICLR, 2015.
[21] Oleksii Kuchaiev와 Boris Ginsburg. LSTM 네트워크를 위한 팩토라이제이션 트릭. arXiv preprint arXiv:1703.10722, 2017.
[22] Zhouhan Lin, Minwei Feng, Cicero Nogueira dos Santos, Mo Yu, Bing Xiang, Bowen Zhou, 그리고 Yoshua Bengio. 구조화된 자기 주의(sentence embedding). arXiv preprint arXiv:1703.03130, 2017.
[23] Minh-Thang Luong, Quoc V. Le, Ilya Sutskever, Oriol Vinyals, 그리고 Lukasz Kaiser. 다중 작업 시퀀스 투 시퀀스 학습. arXiv preprint arXiv:1511.06114, 2015.
[24] Minh-Thang Luong, Hieu Pham, 그리고 Christopher D Manning. 주의 기반 신경 기계 번역에 대한 효과적인 접근법. arXiv preprint arXiv:1508.04025, 2015.
[25] Mitchell P Marcus, Mary Ann Marcinkiewicz, 그리고 Beatrice Santorini. 대규모 주석이 달린 영어 코퍼스 구축: 펜 트리뱅크. Computational linguistics, 19(2):313-330, 1993.
[26] David McClosky, Eugene Charniak, 그리고 Mark Johnson. 파싱을 위한 효과적인 자기 학습. NAACL의 인간 언어 기술 컨퍼런스 메인 컨퍼런스에서, 페이지 152-159. ACL, 2006년 6월.
[27] Ankur Parikh, Oscar Täckström, Dipanjan Das, 그리고 Jakob Uszkoreit. A decomposable attention model. Empirical Methods in Natural Language Processing, 2016.
[28] Romain Paulus, Caiming Xiong, 그리고 Richard Socher. A deep reinforced model for abstractive summarization. arXiv preprint arXiv: 1705.04304, 2017.
[29] Slav Petrov, Leon Barrett, Romain Thibaux, 그리고 Dan Klein. Learning accurate, compact, and interpretable tree annotation. 제21회 국제 계산 언어학 회의 및 ACL 제44회 연례 회의 논문집, 페이지 433-440. ACL, 2006년 7월.
[30] Ofir Press와 Lior Wolf. Using the output embedding to improve language models. arXiv preprint 1608.05859, 2016.
[31] Rico Sennrich, Barry Haddow, 그리고 Alexandra Birch. Neural machine translation of rare words with subword units. arXiv preprint rXiv:1508.07909, 2015.
[32] Noam Shazeer, Azalia Mirhoseini, Krzysztof Maziarz, Andy Davis, Quoc Le, Geoffrey Hinton, 그리고 Jeff Dean. 엄청나게 큰 신경망: 희소하게 게이트된 전문가 혼합 레이어. arXiv preprint urXiv:1701.06538, 2017.
[33] Nitish Srivastava, Geoffrey E Hinton, Alex Krizhevsky, Ilya Sutskever, 그리고 Ruslan Salakhutdinov. 드롭아웃: 신경망의 과적합을 방지하는 간단한 방법. Journal of Machine Learning Research, 15(1):1929-1958, 2014.
[34] Sainbayar Sukhbaatar, Arthur Szlam, Jason Weston, 그리고 Rob Fergus. 엔드 투 엔드 메모리 네트워크. C. Cortes, N. D. Lawrence, D. D. Lee, M. Sugiyama, 그리고 R. Garnett 편집, Advances in Neural Information Processing Systems 28, 페이지 2440-2448. Curran Associates, Inc., 2015.
[35] Ilya Sutskever, Oriol Vinyals, 그리고 Quoc VV Le. 신경망을 사용한 시퀀스 투 시퀀스 학습. Advances in Neural Information Processing Systems, 페이지 3104-3112, 2014.
[36] Christian Szegedy, Vincent Vanhoucke, Sergey Ioffe, Jonathon Shlens, 그리고 Zbigniew Wojna. 컴퓨터 비전을 위한 인셉션 아키텍처 재고. CoRR, abs/1512.00567, 2015.
[37] Vinyals & Kaiser, Koo, Petrov, Sutskever, 그리고 Hinton. 문법을 외국어로. Advances in Neural Information Processing Systems, 2015.
[38] Yonghui Wu, Mike Schuster, Zhifeng Chen, Quoc V Le, Mohammad Norouzi, Wolfgang Macherey, Maxim Krikun, Yuan Cao, Qin Gao, Klaus Macherey 등. 구글의 신경망 기계 번역 시스템: 인간과 기계 번역의 격차를 줄이다. arXiv preprint arXiv:1609.08144, 2016.
[39] Jie Zhou, Ying Cao, Xuguang Wang, Peng Li, 그리고 Wei Xu. 신경망 기계 번역을 위한 빠른 연결을 가진 깊은 순환 모델. CoRR, abs/1606.04199, 2016.
[40] Muhua Zhu, Yue Zhang, Wenliang Chen, Min Zhang, 그리고 Jingbo Zhu. 빠르고 정확한 shift-reduce constituent parsing. 제51회 ACL 연례 회의 논문집 (Volume 1: Long Papers), 페이지 434-443. ACL, 2013년 8월.