



GPU가 아직 쓰는 공간을, CPU가 먼저 지우면 안 됩니다
게임 화면을 한 번 그렸다고 생각해 봅시다. CPU는 “이번 프레임에 무엇을 그릴지” 적어서 GPU에 넘겼습니다. CPU 입장에서는 제출이 끝났지만, GPU는 아직 그 내용을 읽고 있을 수 있습니다. 이때 CPU가 같은 명령 메모리를 비우고 새 내용을 적으면 문제가 생깁니다.
이 글의 핵심은 하나입니다. 다시 쓸 공간을 정한 뒤, 그 공간의 이전 GPU 사용이 끝났는지 확인하고 재사용합니다. 이를 위해 Fence로 완료 지점을 표시하고, FrameContext 두 개를 번갈아 사용합니다. 에디터에서는 마지막 ImGui 그리기와 별도 OS 창의 작업까지 이 완료 지점에 포함해야 합니다.
먼저 그림으로 흐름을 잡은 뒤 실제 함수를 읽어 보겠습니다. 기존의 네 동기화 함수와 버그 이력은 아래에 그대로 연결했습니다. 코드는 로컬 YamYam_Engine의 845442b 기준으로 확인했으며, 해당 렌더링 구현은 ce56f16에서 이어집니다. “수정 전 예제”와 “현재 구현”을 구분해 읽으면 됩니다.
1. Draw 호출, 제출, 완료는 서로 다른 순간입니다
다음 코드를 실행하면 CPU는 Command List에 그리기 명령을 기록합니다.
mCommandList->DrawIndexedInstanced(indexCount, 1, 0, 0, 0); // 명령 기록
C++
복사
Command List를 작업 지시서라고 생각하면 편합니다. DrawIndexedInstanced는 지시서에 항목을 쓰고, ExecuteCommandLists는 작성한 지시서를 Queue에 넘깁니다. GPU는 앞선 작업과 의존 관계에 맞춰 실행합니다. 제출 함수가 반환됐다는 사실만으로 그리기가 끝났다고 판단할 수는 없습니다.

그림 1. 파란 줄은 CPU, 초록 줄은 GPU입니다. CPU가 안전한 슬롯 1에서 다음 명령을 준비하는 동안 GPU는 슬롯 0의 명령을 실행할 수 있습니다. 슬롯 0의 Allocator를 다시 쓰는 시점은 오른쪽의 완료 확인 뒤입니다. 막대 길이는 측정값이 아닌 개념 설명입니다.
이름이 비슷한 네 가지를 먼저 구별합니다
이름 | 하는 일 | 이 글에서 볼 질문 |
Command List | 그리기·복사 등의 명령을 기록하는 객체 | 기록을 마치고 Close했는가? |
Command Allocator | 명령 기록에 필요한 메모리를 관리 | 이 메모리의 이전 GPU 사용이 끝났는가? |
Command Queue | 제출한 목록과 Signal을 GPU 실행 흐름에 연결 | 완료 표시 앞에 필요한 작업을 모두 넣었는가? |
Back Buffer | 화면에 표시할 픽셀을 담는 이미지 | 지금 어느 백버퍼에 그릴 것인가? |
특히 Allocator Reset과 Command List Reset은 같은 작업이 아닙니다. 여기서 반드시 기다려야 하는 핵심 대상은 재사용할 Allocator의 이전 GPU 사용입니다. GPU가 그 Allocator를 사용하는 중에 Reset하면 동작이 보장되지 않습니다. Microsoft: CommandAllocator::Reset
2. Fence는 “여기까지 끝났다”를 숫자로 확인하는 방법입니다
Queue에 “앞선 작업이 끝나면 완료 값을 10으로 만들어 달라”는 표시를 넣었다고 해 봅시다. 이것이 이 엔진에서 사용하는 mCommandQueue->Signal(fence, 10)의 의미입니다. Signal 호출은 완료 예약이고, 완료 값이 10에 도달한 것이 실제 완료 확인입니다.
CPU는 GetCompletedValue()로 완료 값을 읽습니다. 이 엔진처럼 값을 계속 증가시키는 규칙에서는 “10 이상인가?”를 비교하면 됩니다. 이 글은 하나의 엔진 Queue에서 사용하는 경우를 설명합니다. Fence 자체는 Queue 사이의 동기화 등에도 사용할 수 있습니다.
기존 Fence 그림도 함께 보겠습니다. CPU가 신호를 예약하는 순간과 GPU가 그 지점까지 도달하는 순간을 나눠 보세요.
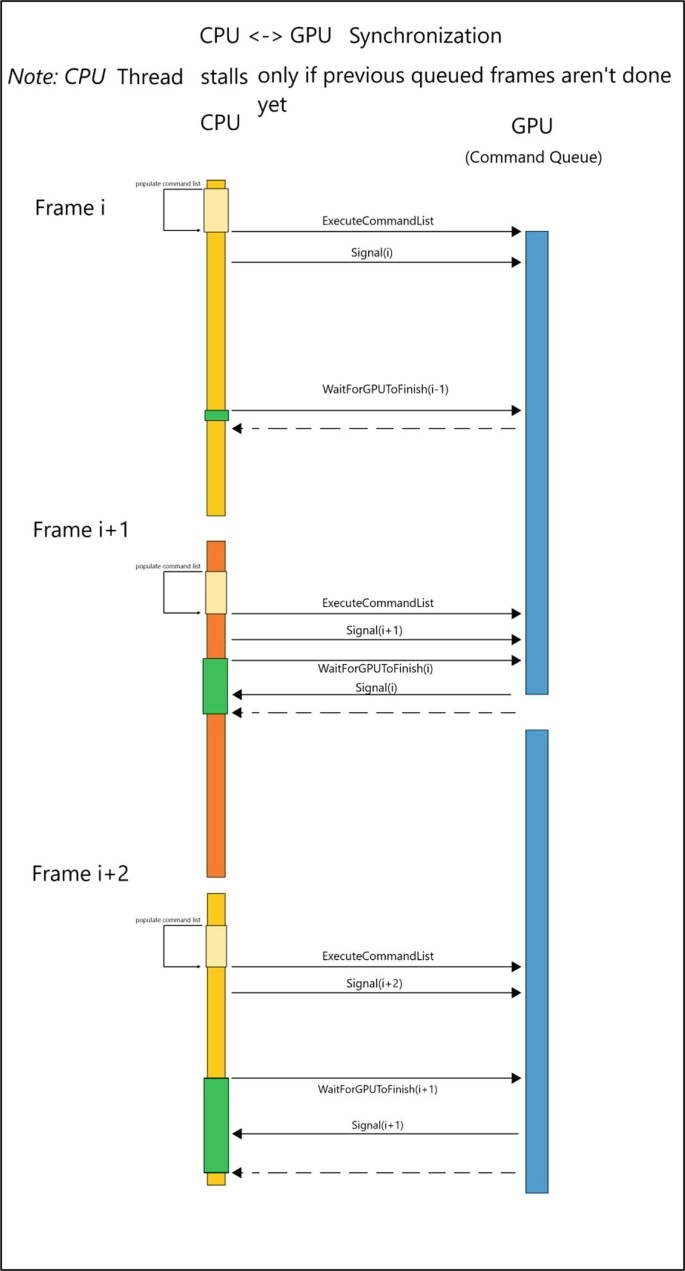
위 그림은 원문에 있던 참고 그림입니다. YamYam 코드에서는 아래의 두 숫자를 구별하면 읽기가 쉬워집니다.
값 | 뜻 |
mFenceLastSignalValue | CPU가 마지막으로 예약한 완료 번호 |
mFence->GetCompletedValue() | GPU 실행 흐름이 실제로 완료한 번호 |
번호는 증가시키되, 프레임 번호와 같다고 외우지 않습니다
// GraphicDevice_DX12.h
UINT64 mFenceLastSignalValue; // 초깃값 0, 이후 단조 증가
// 신호를 보낼 때마다 반드시 이전 값보다 크게 설정
UINT64 fenceValue = mFenceLastSignalValue + 1;
mCommandQueue->Signal(mFence.Get(), fenceValue);
mFenceLastSignalValue = fenceValue;
C++
복사
이 엔진은 10, 11, 12처럼 증가하는 번호를 사용합니다. 그러면 “완료 값이 목표 이상인가?”로 안전 여부를 비교할 수 있습니다. 업로드를 기다릴 때도 같은 카운터를 사용하므로 Fence 번호가 화면 프레임 번호와 항상 같지는 않습니다.
작은 값으로 Signal하는 행위 자체가 DX12에서 무조건 거부된다는 뜻은 아닙니다. 이 엔진이 선택한 완료 값 비교 규칙을 유지하기 위해 번호를 증가시키는 것입니다. 여러 주체가 값을 되감으면 어느 작업의 완료를 뜻하는지 판단하기 어려워집니다.
기다려야 할 때는 이벤트를 사용합니다
아직 목표 번호에 도달하지 않았다면, CPU가 계속 같은 값을 확인하며 돌 필요는 없습니다. “이 값에 도달하면 알려 달라”고 이벤트를 등록하고 현재 스레드를 기다리게 할 수 있습니다.
// 원문의 폴링/이벤트 비교를 정리한 설명용 코드
while (mFence->GetCompletedValue() < targetValue)
{
// 계속 확인하는 busy-wait: 대기하는 동안 CPU 시간을 소비합니다.
}
// 이벤트 방식의 기본 흐름
mFence->SetEventOnCompletion(targetValue, mFenceEvent);
WaitForSingleObjectEx(mFenceEvent, INFINITE, FALSE);
// 실제 적용 시 두 호출의 실패/반환값도 처리해야 합니다.
C++
복사
mFenceEvent는 Win32 이벤트입니다. 완료 조건을 만족해 이벤트가 신호 상태가 되면 대기가 풀립니다. 실제 재사용 여부는 대기가 성공적으로 끝났는지까지 확인해야 합니다.
3. FrameContext 두 개는 번갈아 쓰는 작업 공간입니다
한 공간을 매번 즉시 다시 쓰려면 방금 제출한 작업이 끝날 때까지 기다리게 됩니다. 공간을 두 개 준비하면, GPU가 슬롯 0을 사용하는 동안 CPU는 안전한 슬롯 1에 새 명령을 적을 여지가 생깁니다.
YamYam은 메인 SwapChain의 백버퍼 두 개에 맞춰 FrameContext도 두 개 둡니다.
// 현재 구조의 핵심을 옮긴 설명용 발췌
struct FrameContext
{
ComPtr<ID3D12CommandAllocator> CommandAllocator;
UINT64 FenceValue = 0; // 이 슬롯의 이전 사용에 대해 기다릴 완료 번호
};
FrameContext mFrameContext[2];
C++
복사
FrameContext.FenceValue는 GPU의 현재 완료 값이 아닙니다. “이 슬롯은 몇 번이 끝나야 다시 써도 되는가?”를 적어 둔 메모입니다. 슬롯을 다시 선택하면 GPU 완료 값과 이 메모를 비교합니다.

그림 2. 두 경우 모두 다음에 쓸 곳은 슬롯 0입니다. 완료 값이 9이면 10을 기다리고, 10이면 슬롯 0을 다시 쓸 수 있습니다. 슬롯 1에 적힌 11까지 무조건 기다릴 필요는 없습니다. 에디터의 표시 지연 조건은 4장에서 따로 확인합니다.
처음 슬롯 0을 제출하고 Fence 1을 적었다면, 다음 슬롯 1에는 Fence 2를 적을 수 있습니다. 다시 슬롯 0으로 돌아왔을 때는 1의 완료를 확인합니다. 슬롯 두 개는 대기 자체를 없애 주지 않습니다. GPU가 아직 그 슬롯을 사용한다면 두 개를 만들어도 기다려야 합니다.
백버퍼와 Allocator는 서로 다른 자원입니다. 백버퍼에는 픽셀이, Allocator에는 명령 기록을 뒷받침하는 메모리가 있습니다. 현재 엔진이 둘을 같은 인덱스로 대응시키는 설계를 택했기 때문에 번호를 일관되게 관리합니다. 백버퍼 0이 늘 표시 전용이고 1이 늘 그리기 전용인 것도 아닙니다.
초깃값 FenceValue = 0은 이 구현에서 대기할 이전 사용이 아직 없다는 약속입니다. 뒤에서 이 값을 0으로 지우는 코드가 나오더라도, 그 대입 자체가 GPU 작업을 끝내는 것은 아닙니다.
4. 에디터가 시작 전에 확인하는 두 가지 조건
Allocator를 안전하게 재사용할 수 있더라도 CPU가 표시할 프레임을 너무 앞서 준비하면 입력 반영이 늦어질 수 있습니다. 그래서 에디터는 자원의 안전과 프레임 진행 속도를 함께 확인합니다.

그림 3. 왼쪽은 메모리 재사용의 안전, 오른쪽은 표시 지연을 관리하기 위한 조건입니다. WaitForMultipleObjects(..., TRUE, ...)의 TRUE는 등록한 조건을 모두 기다린다는 뜻입니다.
예를 들어 GPU가 슬롯의 명령을 빨리 끝냈어도 표시 쪽의 프레임 진행 조건은 아직 충족되지 않을 수 있습니다. Fence만 보면 메모리 재사용은 가능하지만, 현재 에디터는 SwapChain의 frame latency waitable object도 기다린 뒤 다음 프레임을 시작합니다. Microsoft: DXGI SwapChain 지연 줄이기
현재 초기화 코드의 SetMaximumFrameLatency(2)는 이 엔진의 설정입니다. 모든 프로그램이 항상 두 프레임을 기다린다는 API 규칙은 아닙니다. 원문의 입력 지연 비교도 이 원리를 설명하는 예시로 이해하면 됩니다. 실제로 몇 프레임이 줄어드는지는 표시 방식과 작업 시간에 따라 달라집니다. 게임 모드에도 별도의 지연 정책을 적용할 수 있습니다.
Fence, Barrier, Present는 각각 다른 일을 합니다
장치/호출 | 여기서의 역할 |
Fence + CPU Wait | 해당 공간을 사용한 GPU 작업의 완료를 확인 |
Resource Barrier | GPU가 리소스를 사용하는 상태와 필요한 접근 순서를 연결 |
Frame latency waitable object | 표시 지연 정책에 맞춰 다음 프레임 시작을 조절 |
Present | 완성한 백버퍼를 표시 흐름에 제출 |
PRESENT → RENDER_TARGET → PRESENT 상태 전환을 넣었다고 CPU에서 Allocator를 즉시 Reset해도 되는 것은 아닙니다. Present() 호출이 돌아온 것도 GPU 전체 완료를 뜻하지 않습니다. 현재 Present(1, 0) 역시 모든 환경에서 정확히 60fps를 보장하는 설정은 아닙니다.
5. 네 가지 동기화 함수는 이 순서로 읽으면 쉽습니다
함수 이름을 외우기 전에 두 질문을 나눠 봅시다. 끝에서 “방금 사용한 슬롯의 완료 번호를 남기는 일”, 그리고 재사용 직전에 “그 슬롯의 이전 번호를 기다리는 일”입니다. Editor는 이를 두 함수로 나누고, Game-only는 프레임 끝의 한 함수에 모아 둡니다.
아래 펼침 항목에는 원문의 실제 함수 본문을 유지했습니다. 주석 중 “0 = 미사용”, “확인 완료 표시” 등은 코드 작성 당시 표현이므로, 바로 아래의 설명과 함께 읽어 주세요.
5.1 SignalFrameCompletion — 방금 사용한 슬롯에 번호를 남깁니다
Editor의 프레임 끝에서 호출합니다. 이 함수 안에서는 CPU가 GPU 완료를 기다리지 않습니다.
1.
새 Fence 번호를 만들어 Queue에 Signal합니다.
2.
이번에 실제로 사용한 슬롯에 그 번호를 저장합니다.
3.
반환 예약된 자원들을 그 최종 번호에 연결합니다.
4.
메인 SwapChain에서 다음 백버퍼 인덱스를 읽습니다.
현재 코드 펼치기 · SignalFrameCompletion() · yaGraphicDevice_DX12.cpp:523
순서가 중요합니다. 이번에 슬롯 0을 썼다면 완료 번호도 슬롯 0에 남겨야 합니다. 먼저 인덱스를 1로 바꾸고 저장하면 다른 슬롯에 번호를 적게 됩니다. 그래서 현재 엔진은 메인 Present() 이후에도 저장 시점까지는 이번 인덱스를 유지하고, 그다음 GetCurrentBackBufferIndex()로 갱신합니다.
SealRetiredResources(fenceValue)는 “나중에 반환할 자원”에 최종 완료 번호를 붙이는 함수입니다. 왜 필요한지는 추가 OS 창 사례에서 다시 보겠습니다.
5.2 WaitForNextFrameResources — Reset보다 먼저 사용 허가를 받습니다
다음 Editor 프레임이 시작될 때 호출합니다. 이미 정해진 mFrameIndex의 FrameContext를 읽고, 그 슬롯의 이전 번호와 표시 지연 조건을 기다립니다. 이 함수에서는 인덱스를 증가시키지 않습니다.
현재 코드 펼치기 · WaitForNextFrameResources() · yaGraphicDevice_DX12.cpp:544
코드가 frameCtx->FenceValue = 0을 먼저 실행하더라도 GPU 완료를 강제로 만드는 것은 아닙니다. 목표 번호는 지역 변수 fenceValue에 복사해 두었고, 그 번호의 이벤트를 실제로 기다립니다. GPU가 이미 목표에 도달했다면 Fence 조건은 즉시 충족될 수 있습니다.
대기가 성공적으로 끝난 뒤 application.Run()이 Allocator와 Command List를 Reset하고 새 명령을 기록합니다. 일부 Signal·이벤트 등록·Wait 반환값 검사는 현재 소스에서 보완할 부분입니다. 원문 코드가 모든 실패 경로까지 처리한 완성형 예제라는 뜻은 아닙니다.
5.3 MoveToNextFrame — Game-only에서는 두 일을 끝에서 묶습니다
Game-only 경로는 이번 슬롯에 Signal 번호를 남긴 뒤 다음 인덱스를 읽고, 다음에 재사용할 슬롯의 이전 번호가 아직 미완료일 때만 기다립니다.
현재 코드 펼치기 · MoveToNextFrame() · yaGraphicDevice_DX12.cpp:571
슬롯 1에 이번 번호 11을 남기고 다음 슬롯 0에 적힌 10을 기다리는 상황을 떠올려 보세요. 방금 제출한 11을 곧바로 전부 기다리는 구조가 아닙니다. Game-only도 CPU/GPU 작업을 겹칠 수 있습니다. 겹침의 바탕은 여러 슬롯을 안전하게 돌려 쓰는 데 있습니다.
5.4 WaitForGpu — 해당 Queue에 앞서 제출한 작업을 기다립니다
리사이즈, 종료, 업로드 완료처럼 앞선 제출이 끝나야 다음 일을 할 수 있는 곳에서 사용합니다. Queue 끝에 새 Signal을 넣고 CPU가 그 번호를 기다립니다.
현재 코드 펼치기 · WaitForGpu() · yaGraphicDevice_DX12.cpp:504
범위는 이 Signal보다 앞서 해당 Queue에 제출된 작업입니다. 아직 기록 중이라 제출하지 않은 목록이나 아무 관계없는 다른 Queue까지 자동으로 완료시키지는 않습니다. 매 프레임 불필요하게 이 대기를 넣으면 CPU/GPU가 겹쳐 일할 기회가 줄어듭니다. 성능 감소가 항상 특정 비율로 고정되는 것은 아닙니다.
6. ImGui가 들어오면 “마지막으로 그리는 사람”이 달라집니다
게임만 실행할 때는 게임 Draw를 기록한 뒤 메인 목록을 닫으면 됩니다. 에디터에서는 게임 이미지 외에 Scene/Game 탭, 메뉴 등 ImGui 화면을 그리는 명령도 추가해야 합니다.

그림 4. 저장소에 보관된 YamYam 에디터의 실제 실행 캡처입니다. 큰 Scene 영역과 앞쪽 Game 창에 이미지가 각각 보입니다. 이 화면을 만들 때 게임 이미지의 렌더링과 ImGui UI 합성 명령이 모두 필요합니다. 화면 배치를 보여 주는 참고 캡처이며, 이 이미지 한 장으로 GPU 동기화가 올바르다는 것을 증명하지는 않습니다.
application.Run()은 게임 렌더링 명령을 기록합니다. 이어 에디터의 ImguiEditor::End()가 메인 백버퍼를 다시 바인딩하고, SRV heap을 설정한 뒤 ImGui_ImplDX12_RenderDrawData()로 ImGui 그리기를 같은 메인 Command List에 추가합니다.
그 다음 메인 백버퍼를 RENDER_TARGET → PRESENT로 전환하고 목록을 닫습니다. 여기서 마지막 Barrier와 Close를 넣는 주체는 YamYam의 ImguiEditor 래퍼입니다. Dear ImGui의 DrawData 함수가 모든 엔진에서 자동으로 목록을 닫아 주는 것으로 이해하면 안 됩니다.
게임 코드가 먼저 이 목록을 닫아 버리면 같은 기록에 ImGui Draw를 계속 덧붙일 수 없습니다. 현재 WITH_EDITOR 분기가 Close의 주체를 나누는 이유입니다.
현재 main.cpp의 한 프레임을 따라갑니다
[Editor]
WaitForNextFrameResources 재사용할 슬롯 + 표시 지연 조건 확인
→ application.Run Reset 후 게임 렌더링 기록
→ EditorApplication::Run Scene/UI 처리, ImGui Draw, 최종 Barrier와 Close
→ ExcuteCommandList 메인 목록 제출
→ UpdatePlatformWindows 추가 OS 창의 렌더링·Present
→ Present 메인 창 표시 요청
→ SignalFrameCompletion 이번 슬롯 번호 저장 → 다음 인덱스
→ EndOfFrame 프레임 끝 이벤트 처리
[Game-only]
application.Run Reset 후 게임 렌더링 기록
→ CloseCommandList 최종 Barrier와 Close
→ ExcuteCommandList 메인 목록 제출
→ Present 메인 창 표시 요청
→ MoveToNextFrame 이번 번호 저장 → 다음 슬롯의 이전 사용 대기
→ EndOfFrame 프레임 끝 이벤트 처리
Plain Text
복사
ExcuteCommandList는 현재 엔진에 쓰인 함수명 철자입니다. Game-only의 다음 반복은 앞선 MoveToNextFrame에서 슬롯의 안전을 확인한 상태로 들어갑니다.
책임 | Game-only | Editor |
메인 목록의 최종 Close | application.CloseCommandList() | ImguiEditor::End() |
이번 슬롯 Signal·인덱스 갱신 | MoveToNextFrame() | SignalFrameCompletion() |
다음 슬롯 재사용 대기 | 이전 반복 끝의 MoveToNextFrame() | 이번 반복 시작의 WaitForNextFrameResources() |
추가 OS 창 제출 | 없음 | 현재 엔진은 메인 Present 전에 수행 |
CPU/GPU 작업 겹침 | 가능 | 가능 |
이 책임 분리는 현재 엔진의 설계입니다. 향후 게임과 UI를 모두 기록한 뒤 공통 코드가 Barrier와 Close를 맡도록 정리할 수도 있습니다.
7. Game 탭을 별도 OS 창으로 꺼내면 무엇이 더 필요할까요?
Docking은 탭을 붙이고 배치하는 기능입니다. Multi-Viewport는 패널을 메인 창 밖의 별도 운영체제 창으로 꺼내는 기능입니다. 아래 공식 예시를 보면 차이가 눈에 들어옵니다.

그림 5. Dear ImGui 공식 Multi-Viewports 위키의 화면 예시. 메인 렌더링 창 주변에 독립된 제목 표시줄을 가진 도구 창들이 떠 있습니다. YamYam 실행 화면이 아닌 기능 설명용 원본 이미지입니다. 출처: ocornut/imgui Wiki.
YamYam의 UpdatePlatformWindows() 래퍼는 ImGui의 플랫폼 창 갱신과 RenderPlatformWindowsDefault()를 호출합니다. 메인 창 목록을 제출한 뒤에도 추가 창의 렌더링 제출이 남아 있다는 점이 핵심입니다.
Game 탭을 밖으로 꺼냈다면 그 창은 Game 텍스처를 SRV를 통해 읽어 화면에 표시합니다. SRV descriptor는 “GPU가 어느 텍스처를 읽을지” 알려 주는 항목입니다. 메인 창 제출이 끝났다는 이유만으로 그 descriptor를 재사용하면 추가 창이 아직 참조하는 항목을 바꿀 위험이 있습니다. 배치에 따라 같은 텍스처를 읽는 창이 여러 개일 수도 있습니다.

그림 6. 현재 엔진은 추가 창에도 엔진의 Command Queue를 전달하도록 DX12 백엔드를 수정했습니다. 따라서 추가 창의 사용을 최종 Signal 앞에 포함할 수 있습니다. 추가 창은 자체 SwapChain과 Allocator를 가지며, 메인 FrameContext의 Allocator를 그대로 공유하는 구조는 아닙니다.
중요한 조건은 완료 번호 앞에 마지막 소비자의 제출까지 들어가 있어야 한다는 것입니다. “추가 창을 메인 Present 전에 그린다”는 위치 자체가 모든 DX12 프로그램에 강제되는 규칙은 아닙니다. 여기서는 실제 YamYam 호출 순서를 따릅니다.
창 크기를 바꾸어 옛 Texture/SRV를 버리는 경우
창을 리사이즈해 새 렌더 타깃을 만들었다고 가정해 봅시다. CPU 쪽 창은 이미 새 이미지로 바뀌었어도, 앞서 기록·제출한 Draw는 옛 텍스처와 descriptor를 참조할 수 있습니다.
1.
RetireResource에서 옛 자원을 반환 대기 목록에 넣습니다. 즉시 재사용하지 않습니다.
2.
프레임의 마지막 제출 뒤 SealRetiredResources(N)으로 완료 번호를 붙입니다.
3.
CollectRetiredResources가 GPU 완료 값과 비교해, 번호가 확정되고 완료된 항목만 실제로 반환합니다.
현재 구현의 번호 미확정 상태는 UINT64_MAX로 표시됩니다. 중간 텍스처 업로드의 WaitForGpu()가 끝난 것만으로 이 프레임의 모든 소비자가 끝났다고 간주하지 않습니다. 반환 예약은 최종 프레임 Signal에서 연결합니다. 이런 수명 관리 원리는 Microsoft의 Fence 기반 리소스 관리 설명과도 연결됩니다.
상수 버퍼도 같은 원리입니다. BeginFrame에서 NextDraw를 0으로 돌리면 해당 슬롯의 업로드 공간을 처음부터 다시 쓰게 됩니다. 그래서 메인 루프에서 슬롯의 이전 GPU 사용을 기다린 뒤 초기화해야 합니다. BeginFrame이 자체적으로 완료를 기다려 주는 것은 아닙니다.
8. mFrameIndex는 “이번에 쓴 공간”을 끝까지 가리켜야 합니다
현재 엔진은 같은 인덱스로 메인 백버퍼, RTV, FrameContext를 선택합니다. Scene/Game의 별도 렌더 타깃은 이 메인 백버퍼와 구별해야 합니다.
이번 인덱스 선택
→ 해당 슬롯의 이전 사용 완료 확인
→ 해당 Allocator Reset과 명령 기록
→ 이번 백버퍼에 그리기 / 최종 Barrier / 제출
→ Present
→ 이번 슬롯에 Fence 번호 저장
→ GetCurrentBackBufferIndex()로 다음 인덱스 갱신
Plain Text
복사
Editor에서 갱신은 SignalFrameCompletion, Game-only에서는 MoveToNextFrame이 맡습니다. WaitForNextFrameResources에서 한 번 더 증가시키면 기다린 슬롯과 실제 기록할 대상의 대응이 어긋날 수 있습니다. 정상 프레임 진행에서는 SwapChain이 알려 주는 현재 백버퍼 인덱스를 따라갑니다.
9. 기존 버그 이력은 세 가지 순서 문제로 기억합니다
9.1 프레임 시작에 인덱스를 한 번 더 증가시켰습니다
// 잘못된 코드 (수정 전)
FrameContext* GraphicDevice_DX12::WaitForNextFrameResources()
{
mFrameIndex = (mFrameIndex + 1) % 2; // ← 이게 문제였다
FrameContext* frameCtx = &mFrameContext[mFrameIndex];
// ...
}
C++
복사
이미 프레임 끝에서 다음 인덱스를 정했는데 시작에서 다시 증가시키면 슬롯 대응이 깨집니다. 수정은 인덱스 갱신을 Present 이후의 종료 함수로 모으고, 시작 함수에서는 읽기만 하는 것입니다. 수동 순환 계산을 SwapChain의 현재 인덱스와 혼용하지 않습니다.
9.2 초기 완료 번호의 약속이 불명확했습니다
// 잘못된 코드 (수정 전)
void GraphicDevice_DX12::Initialize()
{
// ...
mFenceLastSignalValue++; // ← 0 → 1로 만들어버림
}
C++
복사
기존 수정에서는 초기화 중 불필요한 mFenceLastSignalValue++를 제거하고 0에서 시작하도록 정리했습니다. 여기서 교훈은 “1로 시작하면 항상 오류”가 아닙니다. 초기 완료 값, 다음에 Signal할 값, 슬롯에 저장한 값이 서로 맞아야 한다는 것입니다.
전역 카운터가 1이 되었다고 각 슬롯의 0도 자동으로 1이 되지는 않습니다. 아직 Signal하지 않았고 앞으로도 도달하지 않을 값을 기다리게 되면 멈출 수 있습니다.
9.3 Allocator Reset 뒤에 기다렸습니다
수정 전: application.Run에서 Reset → ImguiEditor::End 안에서 Wait
수정 후: main.cpp 시작에서 Wait → application.Run에서 Reset
Plain Text
복사
GPU 사용이 끝났는지 확인하기 전에 메모리를 재사용하도록 만든 것이 문제였습니다. 뒤늦게 기다려도 앞선 Reset을 안전하게 되돌릴 수는 없습니다. Wait는 그 Allocator의 Reset보다 먼저 와야 합니다.
10. 코드를 고치기 전, 이 세 상황을 설명해 봅시다
1.
GPU 완료 값은 9이고, 다음에 쓸 슬롯 0에는 10이 적혀 있습니다. 무엇을 기다릴까요?
2.
완료 값이 10이 됐습니다. 슬롯 1의 11도 기다려야 슬롯 0을 쓸 수 있을까요?
3.
메인 창 제출 뒤에 별도 Game 창 제출이 남았습니다. 그 텍스처의 반환 번호를 어디에 붙여야 할까요?
답과 이유 확인
소스에서 다시 찾아볼 위치
검토 기준은 D:\Github\YamYam_Engine의 845442b7d756e7a991c09799ab58a775803a006a입니다. 이번 문서는 소스와 API 문서를 대조해 고쳤으며, 엔진을 새로 실행하거나 GPU 동작을 측정한 결과를 추가한 것은 아닙니다.
이어서 읽을 구현
이 완료 번호는 명령 메모리뿐 아니라 Texture·RenderTarget·descriptor의 GPU 수명에도 사용됩니다. 다음 글에서 Scene/Game 이미지를 만들고 ImGui에 연결하는 과정으로 이어집니다.